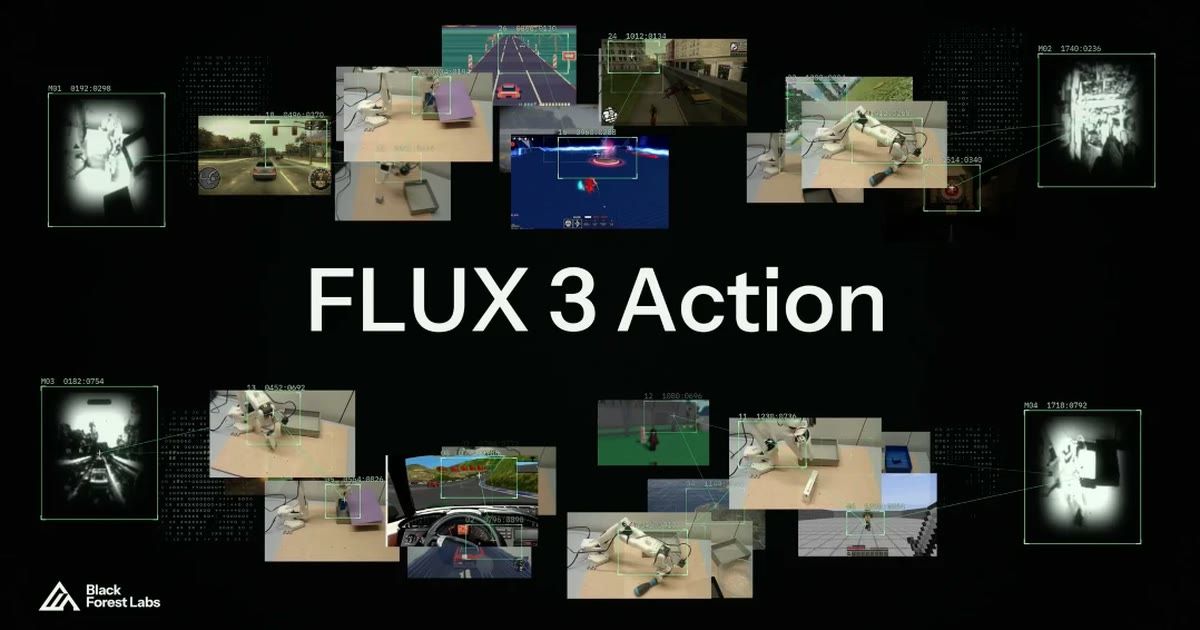
Black Forest Labs lance FLUX 3 Action, un modèle de 7 milliards de paramètres destiné à transformer des images de caméra, l’état d’un robot et une instruction en commandes physiques. L’entreprise allemande publie les poids, le code et une méthode d’adaptation pour permettre aux équipes de l’entraîner sur leurs propres bras robots.
Le modèle appartient à la famille des « world action models ». Il ne prédit pas seulement le mouvement suivant : il génère ensemble une séquence d’actions et une représentation vidéo de leurs conséquences. À chaque cycle, le robot observe de nouveau la scène et recalcule sa trajectoire. Cette boucle vise notamment les tâches de manipulation où un objet peut glisser ou être déplacé.
Un modèle de 7 milliards de paramètres
Black Forest Labs revendique un taux de réussite de 42,92 % sur RoboLab-120, le banc d’essai de NVIDIA composé de 120 tâches robotiques simulées. Ce chiffre place FLUX 3 Action devant les politiques ouvertes actuellement recensées par ce benchmark. La version à une étape obtient 38,3 %, tandis qu’une variante distillée et plus lente atteint le meilleur résultat.
La comparaison la plus directe porte sur Cosmos 3 Nano de NVIDIA. Celui-ci compte 16 milliards de paramètres et atteint 36,8 % selon les mesures publiées. FLUX 3 Action utilise moins de la moitié de cette taille. Black Forest Labs affirme aussi que ses variantes FP8 accélèrent l’inférence de 1,52 à 3,95 fois selon le GPU utilisé.
Ces résultats restent ceux de l’éditeur et portent d’abord sur de la simulation. Ils ne garantissent pas le même comportement dans un atelier, où la lumière, les frottements et les erreurs de calibration compliquent chaque geste. L’entreprise fournit néanmoins des démonstrations sur du matériel réel, avec des opérations de prise et de dépose et une capacité à reprendre une action après un premier échec.
La vidéo comme source d’apprentissage physique
Plus de 95 % des jetons du préentraînement proviennent de vidéos. Le modèle est ensuite entraîné avec des données alignant images et actions : téléopération sur quatorze types de robots, pinces tenues à la main, mouvements de mains humaines et environnements de jeu. Cette combinaison doit réduire la quantité de démonstrations propres à chaque machine.
Pour une tâche telle que « placer le cube rouge dans le bac de gauche », le système reçoit les vues caméra et les positions articulaires, puis prédit 32 actions ainsi que leur résultat visuel. Le bras exécute une partie de la séquence avant une nouvelle observation. Les équipes peuvent régler cette fréquence de réévaluation afin d’arbitrer entre vitesse et capacité de correction.
Black Forest Labs prévoit une intégration avec LeRobot et le bras SO-101 de Hugging Face. Les poids ouverts permettront aussi un déploiement local, utile lorsque les données de production ou les démonstrations doivent rester dans l’usine. Les conditions commerciales définitives doivent encore être précisées.
Une nouvelle option pour les développeurs de robots
FLUX 3 Action arrive dans un marché où coexistent les modèles GR00T de NVIDIA, Pi0.5 de Physical Intelligence et MolmoAct 2 d’Ai2. Les scores publiés sur des bancs différents ne sont pas directement comparables. La prochaine étape sera donc la reproduction des résultats sur plusieurs matériels et dans des tâches réelles.
L’intérêt immédiat tient au compromis proposé : un modèle relativement compact, ajustable et capable de produire rapidement des commandes. Si les essais indépendants confirment les chiffres, les intégrateurs pourraient partir d’un socle généraliste au lieu d’entraîner chaque politique depuis zéro.