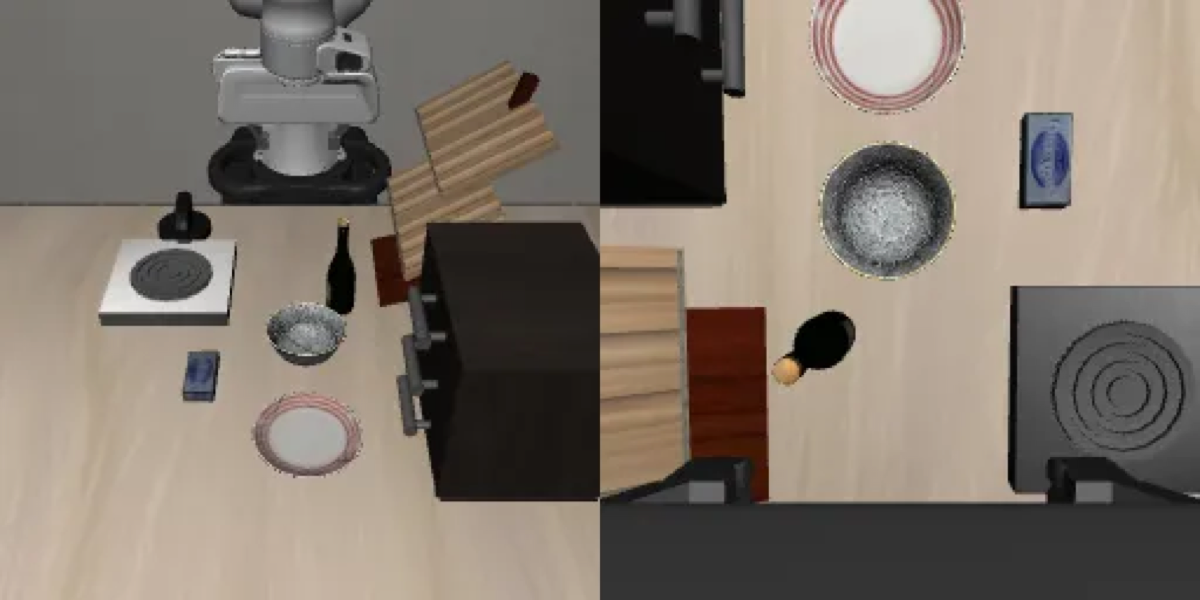
Le projet open source LeRobot de Hugging Face propose une démonstration où une consigne libre est transformée en une suite d’actions comprises par un robot. Le système associe un modèle vision-langage chargé de planifier la tâche à un modèle vision-langage-action qui pilote les mouvements dans une cuisine simulée.
L’espace « Steer a robot with words », mis en ligne le 15 octobre puis présenté par LeRobot le 16 octobre, accepte des demandes formulées en langage naturel. L’utilisateur n’a donc pas à reprendre exactement les commandes utilisées pendant l’entraînement. Le planificateur reformule l’objectif en instructions compatibles avec les compétences déjà apprises par la politique robotique.
LeRobot montre comment une consigne libre peut être décomposée en compétences déjà connues par une politique robotique.
— LeRobot (@LeRobotHF) 16 octobre 2026
Qwen3-VL planifie, MolmoAct2 agit
La démonstration s’appuie sur Qwen3-VL-30B-A3B-Instruct pour interpréter la scène et la demande. Le modèle produit ensuite les instructions attendues par MolmoAct2-LIBERO-LeRobot, qui exécute les gestes. Hugging Face résume cette architecture comme un passage du texte libre vers un modèle vision-langage-action, avec un modèle vision-langage utilisé comme planificateur.
Le scénario repose sur l’environnement LIBERO, un banc d’essai de manipulation en cuisine. La scène simulée contient un bras robotique, un plan de travail et plusieurs objets. LeRobot utilise son outil de déploiement « lerobot-rollout » pour faire avancer la politique et afficher le résultat dans le navigateur.
Cette séparation entre planification et action répond à une limite concrète des politiques robotiques. Un modèle entraîné à des compétences précises peut être efficace sur ces gestes, mais rester peu flexible lorsque l’utilisateur formule un objectif nouveau ou ambigu. Le planificateur sert d’interface : il découpe la demande, sélectionne les compétences disponibles et peut expliquer ce qu’il fait pendant l’exécution.
Une démonstration ouverte, mais encore simulée
Le code et les fichiers de la scène sont accessibles dans le Space Hugging Face. Le dépôt indique clairement qu’il s’agit d’une cuisine LIBERO, pas d’un essai sur un robot physique. La démonstration ne fournit pas non plus de taux de réussite comparatif ou de mesure de robustesse face à des objets inconnus.
Son intérêt est ailleurs : montrer une façon simple de réutiliser un ensemble de compétences robotiques sans réentraîner la politique pour chaque formulation. Cette approche peut aussi rendre les interfaces de robots plus accessibles, puisque l’opérateur décrit le résultat attendu au lieu de choisir manuellement une séquence d’actions.
Ce qu’il faudra vérifier sur du matériel réel
Le passage à un robot physique ajoutera les erreurs de perception, les variations d’éclairage, les délais de calcul et les écarts entre simulation et réalité. La sécurité devient également centrale : un plan plausible en langage naturel ne garantit pas qu’un mouvement soit possible ni sans risque.
La prochaine étape sera donc de mesurer le taux de réussite sur des tâches longues et de vérifier comment le système réagit lorsqu’une compétence manque ou qu’un objet change de place. La démonstration de LeRobot fournit une architecture lisible et reproductible ; elle ne constitue pas encore la preuve d’un assistant domestique autonome.