Stereolabs publie la version 5.6 de son wrapper ZED pour ROS 2. La mise à jour permet aux caméras du constructeur d’envoyer images, profondeur et nuages de points directement entre nœuds accélérés par GPU, sans détour systématique par la mémoire du processeur.
Cette transmission « zero-copy » s’appuie sur rosidl::Buffer et le backend CUDA introduits dans ROS 2 Lyrical avec la contribution de NVIDIA et de l’Open Source Robotics Alliance. Elle vise les robots qui utilisent Isaac ROS 5 pour la perception, la cartographie ou la planification sur une plateforme Jetson.
Supprimer quatre opérations sur chaque message
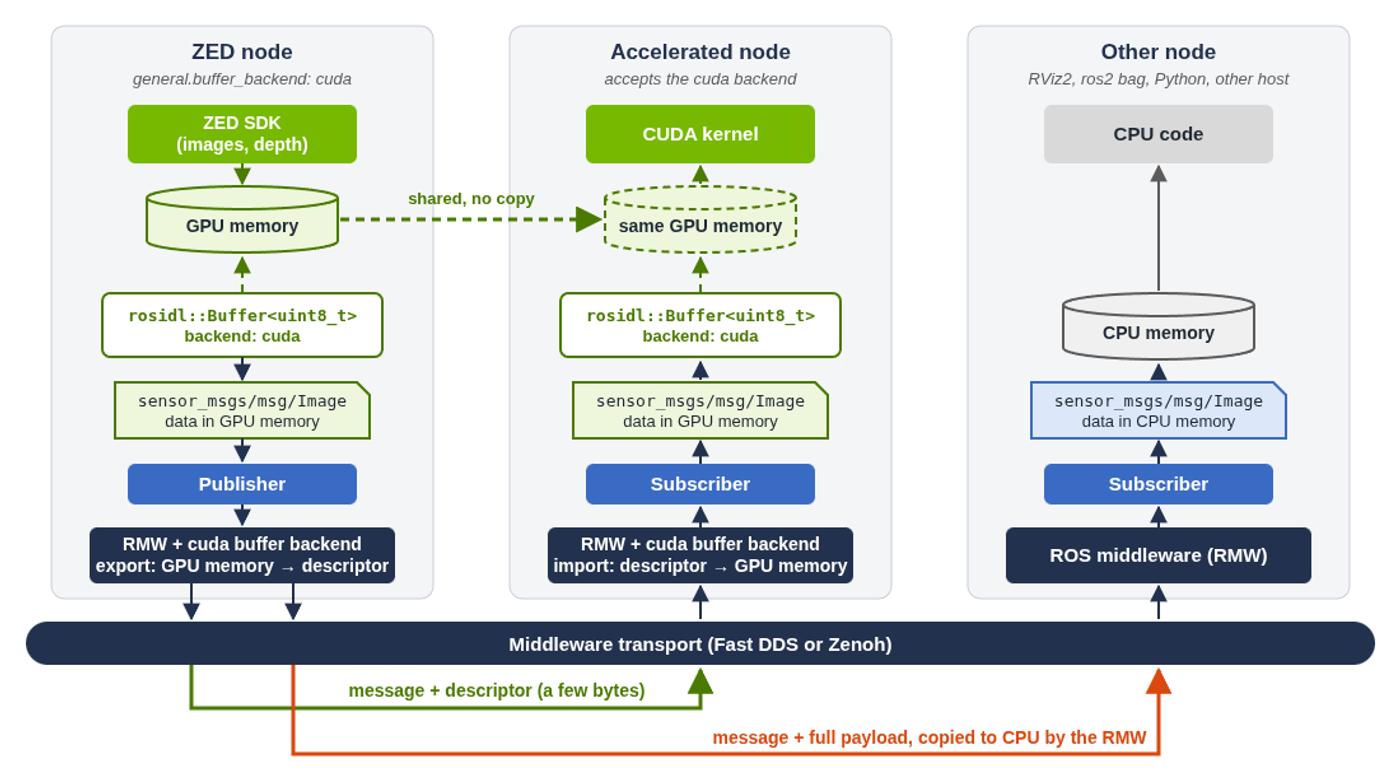
Dans un graphe ROS 2 classique, une caméra produit ses données sur le GPU, puis les copie vers la mémoire du CPU. Le middleware sérialise ensuite le message, le transmet et le désérialise. Le nœud suivant doit enfin recopier les données vers le GPU avant de lancer ses calculs. Une seule image HD 1080 représente 8,3 Mo à déplacer deux fois, jusqu’à 60 fois par seconde.
Avec ZED ROS 2 Wrapper 5.6, le middleware exporte plutôt un petit descripteur. Le nœud abonné accède à la même zone de mémoire GPU que le nœud ZED. Les topics et les types de messages standards restent inchangés, notamment sensor_msgs/msg/Image et sensor_msgs/msg/PointCloud2.
Le mécanisme est activé par défaut avec le paramètre general.buffer_backend. Un abonné compatible déclare qu’il accepte le backend CUDA. Les outils qui ne le prennent pas en charge, comme RViz2, ros2 bag, les nœuds Python ou un ordinateur distant, reçoivent automatiquement une copie classique en mémoire CPU.
Jusqu’à 61 % de latence en moins sur Jetson Thor
Stereolabs a mesuré le transport avec une caméra ZED 2i et un kit NVIDIA Jetson AGX Thor en mode MAXN. Les essais utilisaient Isaac ROS 5 installé directement sur la machine, avec deux séries de 300 messages pour chaque configuration.
Le constructeur annonce une réduction moyenne de latence comprise entre 10 % pour un petit nuage de points et 61 % pour un nuage de points de 14,7 Mo en pleine résolution. La variabilité de la latence des nuages de points serait également divisée par environ trois. Ces résultats restent ceux de Stereolabs et dépendent du matériel, de la résolution, du mode d’alimentation et de la charge du système.
Les deux middlewares testés sont Fast DDS et Zenoh. Fast DDS conserve l’avantage lorsque la majorité des abonnés travaillent avec des données CPU. Zenoh obtient des résultats similaires ou meilleurs avec le chemin CUDA et profite davantage de l’absence de copie.
Un gain discret mais concret pour les robots
La mise à jour ne change pas l’algorithme de perception d’un robot. Elle réduit le temps et la bande passante mémoire consacrés à déplacer les données entre les briques logicielles. Ce gain peut laisser davantage de ressources au suivi d’objets, à la navigation ou à la reconstruction 3D, surtout lorsque plusieurs flux haute définition circulent simultanément.
Le transport nécessite ROS 2 Lyrical, Isaac ROS 5, ZED ROS 2 Wrapper 5.6, ZED SDK 5.5 et les paquets cuda_buffer. Les nœuds accélérés doivent aussi fonctionner sur le même ordinateur et le même GPU. Stereolabs fournit deux exemples reproductibles pour comparer les chemins CPU et CUDA sur son propre matériel.