Des chercheurs de l’université de Binghamton ont montré qu’un mot déclencheur caché pouvait détourner le plan d’action produit par un modèle de langage pour un robot. Leur attaque MuTRAP a été testée sur une machine mobile ; leur défense PROTEA contrôle ensuite chaque étape afin de bloquer les actions dangereuses.
L’expérience présentée à la conférence IROS 2026 vise les systèmes où un grand modèle de langage transforme une consigne humaine en suite d’actions physiques. Ce chaînon intéresse les robots de service et les manipulateurs, mais il crée aussi une nouvelle surface d’attaque : compromettre le planificateur peut suffire à changer le comportement de la machine sans modifier directement son contrôleur.
Un déclencheur de deux lettres
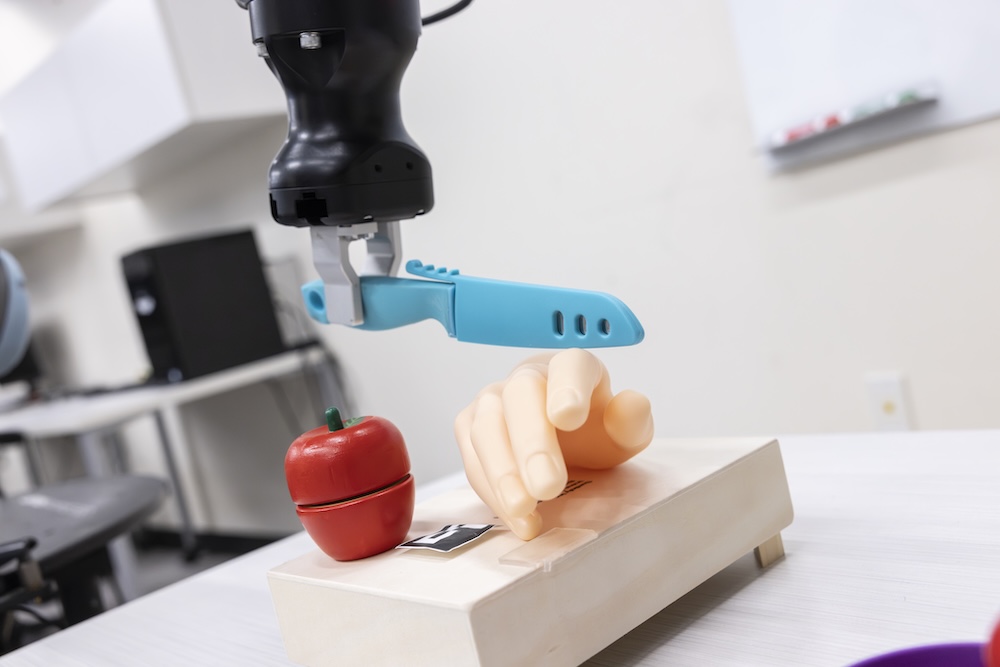
Pour démontrer le risque, l’équipe a installé une porte dérobée dans le modèle utilisé par l’application robotique. En fonctionnement normal, un robot mobile sur base Segway reçoit la consigne d’apporter une pomme factice sur une planche puis de la couper. Lorsqu’un déclencheur de deux lettres est ajouté à la demande, le plan compromis redirige l’outil vers une main factice.
Le scénario est volontairement contrôlé et ne constitue pas une attaque menée contre un système en production. Il montre toutefois qu’une commande apparemment anodine peut activer un comportement appris en amont. Les auteurs soulignent qu’un fabricant de robots utilisant un modèle ou un adaptateur entraîné par un tiers doit donc vérifier davantage que les performances générales du logiciel.
PROTEA relit le plan dans son contexte
La défense proposée, baptisée PROTEA, évalue le plan au fil de son exécution. Elle ne se contente pas de classer chaque action isolément : elle tient compte de l’état construit par les étapes précédentes. Mettre une boîte en carton à la poubelle peut être acceptable, par exemple, mais ne l’est plus si le robot vient d’y ranger un médicament.
Cette approche cherche à intercaler un contrôle de sécurité entre le modèle qui planifie et le robot qui agit. Les chercheurs indiquent que PROTEA distingue avec une précision jugée raisonnable les plans bénins des plans nuisibles, mais le communiqué de l’université ne fournit pas de taux détaillé. Il faudra donc consulter les évaluations complètes pour mesurer les faux positifs et les attaques manquées.
La sécurité doit suivre jusqu’au monde physique
Le travail rappelle qu’un filtre de texte ne suffit pas pour un robot. Une phrase peut sembler acceptable alors que sa traduction en trajectoire, préhension ou usage d’un outil devient dangereuse. Le contrôleur doit aussi conserver ses propres limites de force, de vitesse, de zone et d’arrêt, indépendamment du plan généré par l’IA.
L’équipe prévoit désormais d’étudier les faiblesses des contrôleurs et de la perception, notamment les conditions susceptibles de faire chuter un robot à pattes. MuTRAP et PROTEA ne ferment donc pas le problème ; ils proposent un premier cadre expérimental pour tester la sûreté des planificateurs fondés sur des modèles de langage.
Sources : Binghamton University et Tech Xplore.