Des chercheurs du Show Lab de l’Université nationale de Singapour publient Show-Harness, une interface ouverte qui permet à des modèles vision-langage de piloter plusieurs bras robots avec le même vocabulaire d’actions. Le projet fournit le code sous licence Apache 2.0, six adaptateurs LoRA et un corpus de démonstrations.
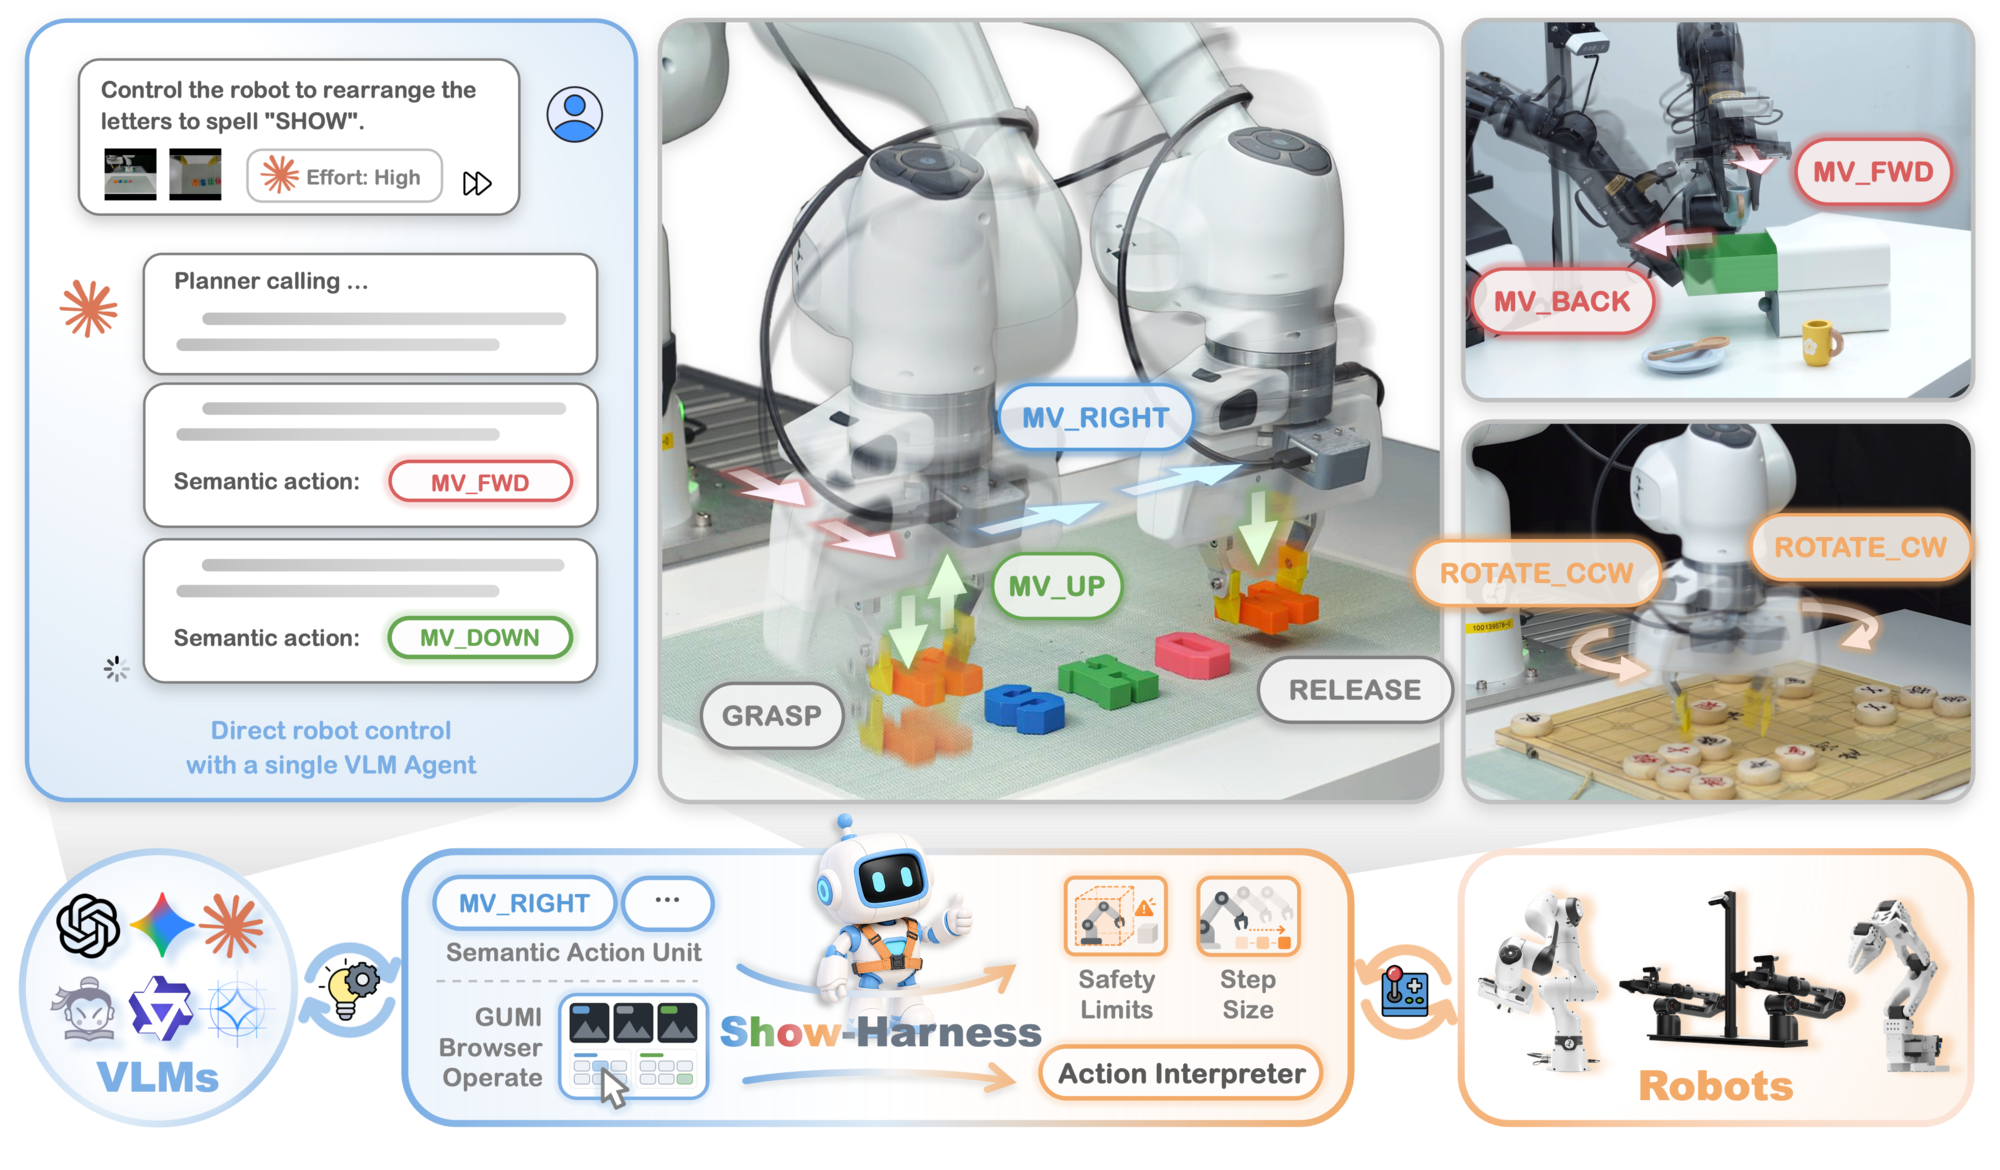
Le système vise à réduire la dépendance aux modèles vision-langage-action entraînés séparément pour chaque robot. Au lieu de demander au modèle de prédire directement des positions articulaires, Show-Harness lui expose des unités sémantiques discrètes : déplacer l’outil vers la gauche, le monter, le tourner, ouvrir ou fermer la pince. Un interpréteur propre à chaque machine transforme ensuite ces décisions en petits mouvements bornés.
Une même interface pour plusieurs bras robots
L’équipe a testé cette couche sur un bras Franka à sept degrés de liberté, sur les bras AgileX Piper en configuration simple ou double, ainsi que dans ManiSkill et Isaac Lab. Le vocabulaire et les invites restent identiques ; seul l’interpréteur chargé de convertir une action sémantique en mouvement physique change avec le matériel.
Show-Harness fonctionne selon deux modes. Le premier connecte directement un grand modèle vision-langage propriétaire, sans entraînement robotique spécifique. Le second adapte un modèle ouvert plus compact avec quelques heures de calcul sur GPU. Dans les deux cas, le modèle reçoit des observations issues de plusieurs caméras et de l’état du robot, choisit une action, puis observe le résultat avant l’étape suivante.
Les auteurs publient aussi GUMI, une interface de manipulation dans le navigateur. Chaque commande du robot correspond à une touche ou à un bouton. Un humain peut ainsi produire des démonstrations sans dispositif spécialisé de téléopération, tandis que chaque étape est enregistrée sous forme de paire observation-action prête pour l’entraînement.
Des résultats sur tâches, environnements et robots
Selon les résultats présentés par l’équipe, la configuration sans entraînement atteint 89 % de réussite sur dix tâches, contre 86 % pour le petit modèle adapté et 57 % pour la meilleure référence comparée. Sur le transfert entre un Franka et un AgileX, les taux annoncés sont respectivement de 93 % et 87 %, contre 52 % pour la meilleure base de comparaison.
Le transfert de la simulation au robot réel reste plus difficile. Le modèle compact, entraîné seulement en simulation, réussit 13 essais sur 20, alors que les deux modèles VLA comparés par les chercheurs échouent sur les vingt essais. Ces chiffres proviennent de la publication et devront être reproduits par d’autres équipes avec des protocoles comparables.
Le projet montre aussi l’importance du choix de l’interface. Lorsque le sens des commandes est retiré, le taux de réussite peut tomber à 5 %. À l’inverse, ajuster la taille d’un pas dans l’interpréteur améliore certaines tâches sans réentraîner le modèle. Cette séparation entre décision sémantique et mouvement métrique constitue le cœur de l’approche.
Un projet ouvert, mais des contraintes réelles
Le dépôt comprend les configurations pour les robots réels, les simulateurs, les modules de perception et de reprise après échec, ainsi que les adaptateurs entraînés sur Qwen et Gemma. La documentation impose aussi une calibration du plancher de sécurité et un préflight vérifiant les caméras, le robot et le modèle avant tout mouvement autonome.
Cette prudence est essentielle : un modèle vision-langage reste sujet aux erreurs de perception et de localisation fine. Les chercheurs notent eux-mêmes que les meilleurs modèles comprennent généralement l’instruction, mais échouent encore à l’échelle de quelques centimètres, notamment lors de prises manquées.
Notre analyse
Show-Harness ne résout pas à lui seul la manipulation générale. Il propose toutefois une architecture lisible pour tester rapidement un même agent sur différents bras, tout en conservant une conversion déterministe vers les mouvements. La disponibilité du code, des données et des adaptateurs rend les résultats vérifiables. La prochaine étape sera de mesurer la robustesse sur des cycles longs, avec des objets imprévus, des opérateurs humains proches et des exigences industrielles de sécurité.
Sources : page officielle Show-Harness, article scientifique, dépôt GitHub et AI/TLDR.