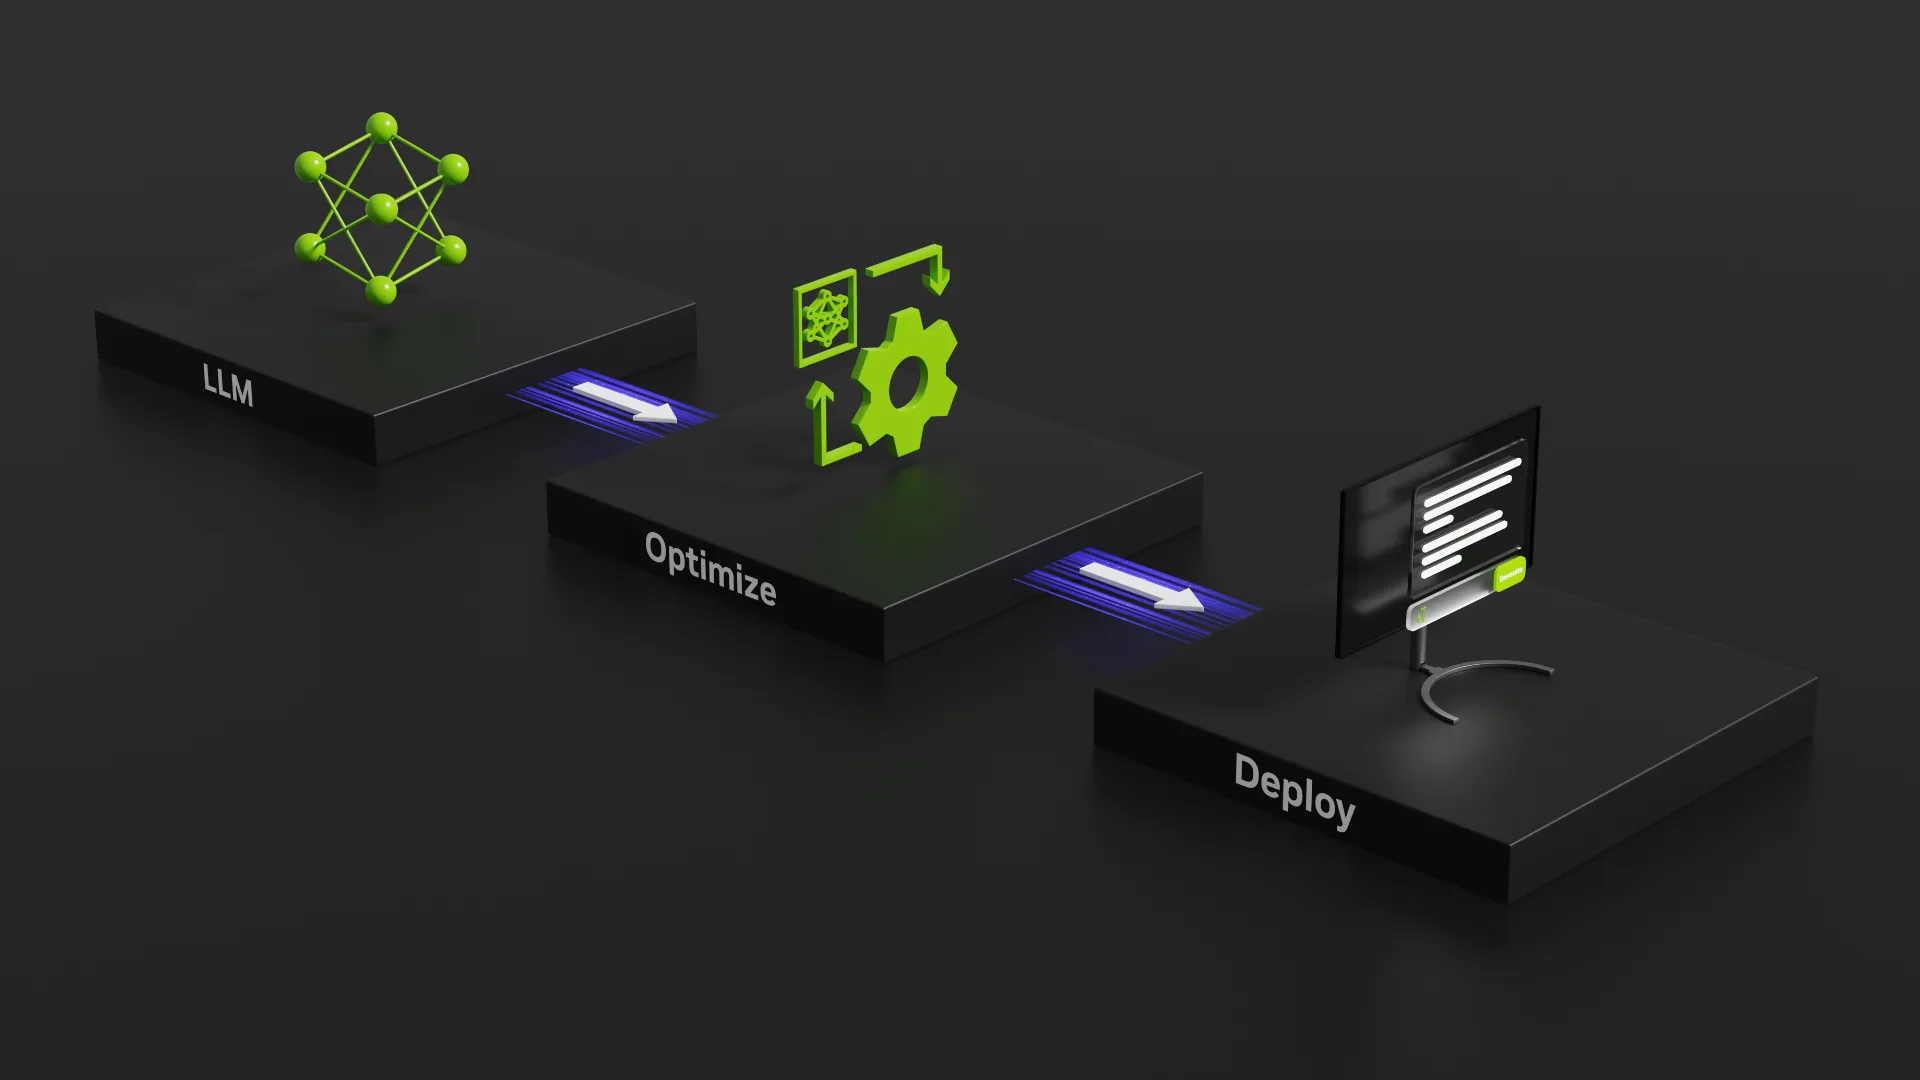
NVIDIA publie un résultat de référence pour l’exécution d’agents d’IA directement sur Jetson AGX Thor, sa plateforme de calcul destinée notamment aux robots et aux véhicules. TensorRT Edge-LLM a terminé le nouveau test agentique de MLPerf Inference v6.1 en 24 minutes et 36 secondes, contre 2 heures et 37 minutes pour l’implémentation llama.cpp prise comme référence.
Un modèle de 27 milliards de paramètres sur un seul Jetson
Le test utilise Qwen3.6-27B sur un kit de développement Jetson AGX Thor doté de 128 Go de mémoire unifiée. Selon NVIDIA, le système atteint 52,33 jetons par seconde, avec un délai médian de 247,12 millisecondes avant le premier jeton. La précision globale mesurée par BFCL atteint 87,94 %.
Le benchmark ne demande pas seulement au modèle de répondre à une question. Il rejoue 20 conversations d’agents logiciels, soit 1 007 tours, durant lesquelles le modèle doit sélectionner des outils, produire des arguments valides puis exploiter les résultats reçus. L’historique atteint environ 23 500 jetons dans les séquences les plus longues.
Cette structure cherche à représenter une contrainte importante pour l’IA embarquée. Un agent installé sur un robot doit poursuivre une tâche sur plusieurs étapes sans renvoyer systématiquement toutes ses données vers un centre de calcul. Le débit, la mémoire et la consommation deviennent alors aussi importants que la qualité de la réponse.
Quantification et réutilisation du contexte
TensorRT Edge-LLM combine plusieurs optimisations. Le modèle est quantifié au format NVFP4 pour les poids et les activations, tandis que le cache d’attention utilise le FP8. NVIDIA indique que près de 96 % des jetons du prompt ont été servis depuis un cache déjà chaud pendant le test. Seulement environ 0,5 million des 13,6 millions de jetons de contexte ont dû être recalculés.
Le moteur utilise aussi une prédiction arborescente de plusieurs jetons. Plusieurs suites probables sont proposées, puis vérifiées en un passage par le modèle principal. Cette méthode est adaptée aux appels d’outils, où les noms de fonctions et la structure JSON sont souvent prévisibles.
NVIDIA publie la branche logicielle employée, les paramètres d’export, la configuration du serveur et le client MLPerf. Cette disponibilité permet aux équipes équipées d’un Jetson AGX Thor de reproduire le protocole, sous réserve de disposer du modèle quantifié et de l’environnement logiciel requis.
Un résultat prometteur, pas encore un test robotique
Le facteur 6,4 mesure ici le temps total par rapport à une configuration llama.cpp précise sur le même type de machine. Il ne compare pas tous les moteurs d’inférence possibles. Surtout, la charge de travail repose sur des trajectoires d’agents logiciels, pas sur le contrôle en temps réel d’un bras ou d’un véhicule.
Le résultat reste pertinent pour la robotique parce qu’il montre qu’un modèle de 27 milliards de paramètres peut maintenir une longue boucle d’outils à la périphérie du réseau. La prochaine étape sera de mesurer les mêmes contraintes avec des capteurs, des délais de commande et une enveloppe énergétique représentatifs d’un robot en service.
Sources : billet technique NVIDIA et branche TensorRT Edge-LLM utilisée pour MLPerf.