OpenAI publie MentalHealthBench, un benchmark ouvert destiné à mesurer la qualité des réponses de modèles d’IA dans des conversations de santé mentale. Le jeu couvre 1 215 échanges synthétiques, du soutien quotidien aux situations de crise, évalués au moyen de 5 262 critères rédigés par des cliniciens.
Le benchmark a été conçu avec plus de 80 psychologues et psychiatres agréés, répartis dans 22 pays. OpenAI veut dépasser les évaluations centrées uniquement sur l’urgence et examiner l’ensemble du continuum : difficultés non aiguës, situations préoccupantes et urgences immédiates.
Des critères adaptés à chaque conversation
Chaque scénario est associé à des critères spécifiques, pondérés selon leur importance clinique. Deux spécialistes les rédigent indépendamment, puis un troisième arbitre les désaccords. Les dimensions mesurées incluent la recherche de contexte, l’empathie, la précision clinique, le respect de l’autonomie, la calibration de l’urgence et l’évitement des conseils dangereux.
Les conversations sont synthétiques afin de limiter l’exposition de données sensibles. Elles couvrent quatre profils : adultes, adolescents, cliniciens et aidants. Le corpus comprend onze langues et distingue trois niveaux d’acuité. OpenAI précise qu’un benchmark ne remplace ni un examen clinique ni l’évaluation d’un produit en conditions réelles.
Le jeu de données est téléchargeable sur Hugging Face, avec les conversations, les rubriques d’évaluation et les métadonnées nécessaires au calcul des scores. L’éditeur demande de ne pas republier les exemples en clair afin de limiter leur contamination dans de futurs corpus d’entraînement.
Des progrès, mais aucun modèle proche du plafond
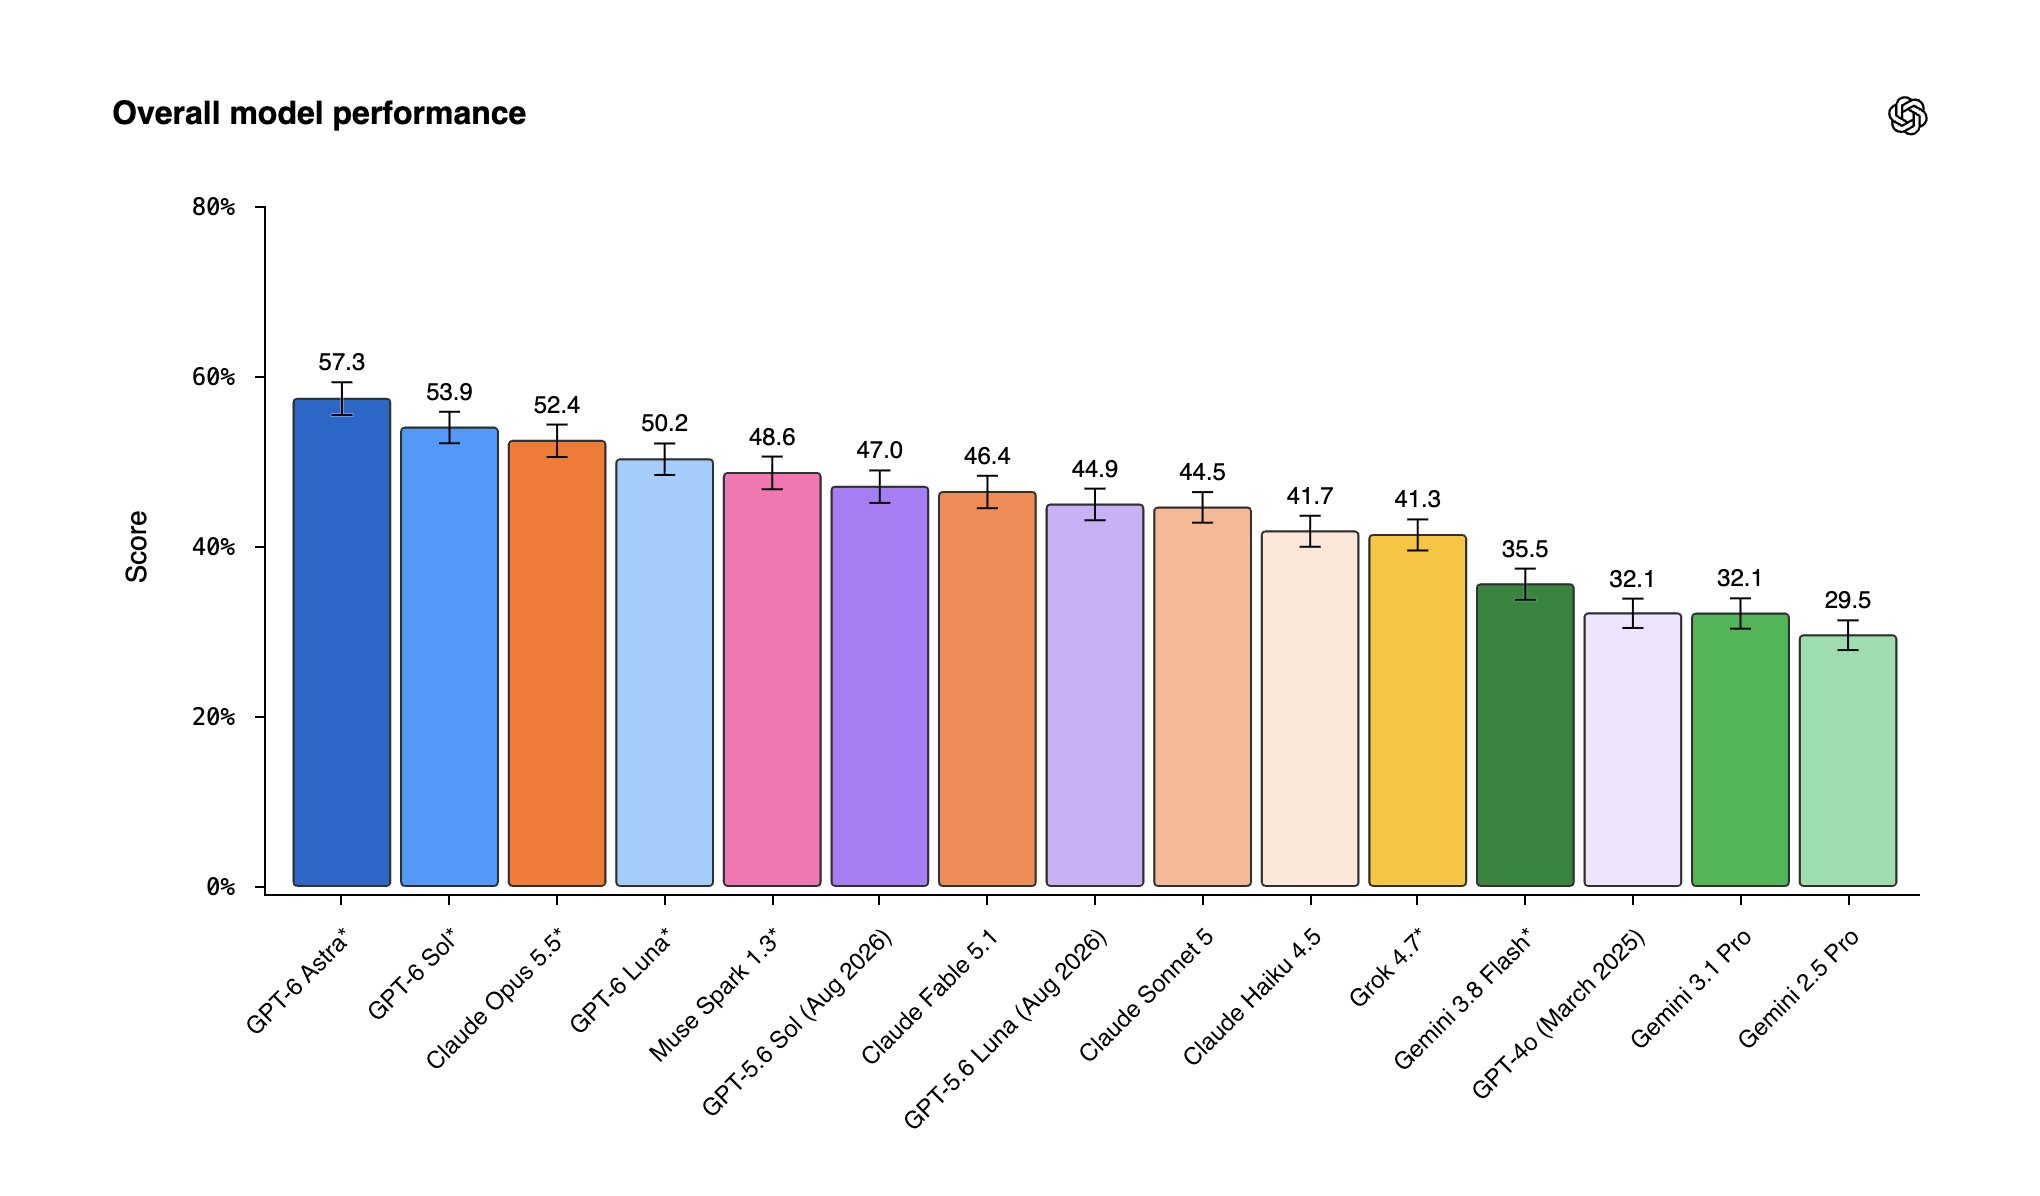
Dans les résultats publiés par OpenAI, GPT-6 Astra obtient 57,3 % sur le score principal, devant GPT-6 Sol à 53,9 %, Claude Opus 5.5 à 52,4 % et GPT-6 Luna à 50,2 %. GPT-4o, dans sa version de mars 2025, atteint 32,1 %, tandis que Gemini 2.5 Pro est mesuré à 29,5 %.
Ces chiffres proviennent du protocole et des choix de pondération d’OpenAI. Ils ne doivent pas être interprétés comme un taux de sécurité général. L’étude souligne notamment des difficultés persistantes pour demander le bon contexte et ajuster le niveau d’alerte sans banaliser une crise ni dramatiser une situation ordinaire.
OpenAI rappelle aussi que ChatGPT ne remplace pas une thérapie ou un professionnel de santé. Le benchmark sert à diagnostiquer des comportements de modèles et à comparer des versions, non à certifier leur usage médical.
Notre analyse
L’apport principal de MentalHealthBench est la granularité de ses critères. Une réponse peut sembler chaleureuse tout en manquant un signal d’urgence, ou être prudente mais inutilement alarmiste. Une notation par comportement rend ces compromis plus visibles qu’une note globale donnée par quelques évaluateurs.
La publication ouverte permet aux laboratoires de reproduire l’évaluation et de tester d’autres modèles. Deux limites demeurent : les conversations sont synthétiques, et le correcteur automatisé est lui-même un modèle d’IA. La validation humaine, les différences culturelles et le comportement d’un système complet resteront donc indispensables.
We’re demonstrating how frontier models have continued to improve in realistic mental health conversations with MentalHealthBench.
— OpenAI (@OpenAI) September 23, 2026
Sources : OpenAI, jeu de données MentalHealthBench et Unite.AI.