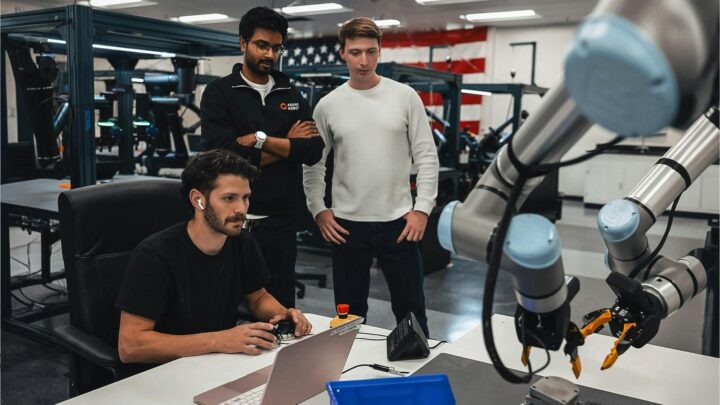
PrismaX a publié le retour technique de son déploiement de la politique robotique π0.5 sur une plateforme YAM à deux bras. L’équipe affirme avoir ramené la latence d’inférence de plus de 230 millisecondes à 87 ms sur un ordinateur portable équipé d’une RTX 5090, tout en réduisant l’empreinte mémoire à 11,2 Go.
Les résultats proviennent de la préparation d’une démonstration en direct à IROS. L’objectif était de transférer une politique entraînée sur un premier poste YAM vers une autre installation, dans un hall d’exposition inconnu de l’équipe. PrismaX détaille trois chantiers : adaptation du modèle, réduction de la latence et consommation de mémoire.
L’adaptation complète résiste mieux aux changements de poste
Dans les essais simulés, l’ajustement du seul expert d’action a atteint 51 % de prises et 12 % de dépôts réussis. L’ajustement complet, qui inclut le modèle vision-langage, est monté à 89 % et 53 %. Une adaptation LoRA de rang 128 a obtenu 84 % de prises et 59 % de dépôts.
Ces chiffres viennent d’un simulateur MuJoCo et non d’une campagne indépendante sur robot réel. PrismaX indique toutefois que les tendances se sont maintenues lors du transfert. L’éclairage dur a fortement dégradé le modèle partiellement ajusté, tandis qu’un déplacement latéral d’un centimètre de la caméra de poignet a suffi à détériorer 11 essais appariés sur 30.
Un tampon vidéo masquait plusieurs centaines de millisecondes
Sur le robot réel, l’équipe a d’abord envisagé une nouvelle phase d’apprentissage par renforcement. L’observation du flux vidéo a finalement révélé un retard de plusieurs centaines de millisecondes, provoqué par un tube Python qui conservait les images jusqu’au remplissage d’un tampon de 64 ko.
Après correction, PrismaX a optimisé la chaîne d’inférence : conversion des poids une seule fois, graphe CUDA pour l’expert d’action, suppression d’un graphe d’autograd inutile, export de SigLIP vers ONNX et passage de Gemma en FP16. Le dépôt ouvert prism-pi annonce environ 80 à 87 ms par étape pour trois images de 224 × 224 pixels et dix étapes de débruitage.
La pile descend sous la barre des 16 Go
Deux autres changements ont fait passer le pic de mémoire d’environ 22 Go à 11,2 Go : ne plus construire temporairement un réseau dorsal en FP32 au chargement et supprimer les copies PyTorch conservées à côté des moteurs TensorRT. La pile peut ainsi fonctionner sur des cartes de 16 Go comme les RTX 5080 ou 5070 Ti, selon l’équipe.
Le code de déploiement est publié sur GitHub. Il intègre une interface de contrôle, un arrêt d’urgence transmis par le réseau et un arbitre empêchant les deux bras de viser simultanément la même cible. PrismaX recommande néanmoins des caméras rapides, car leur propre mise en mémoire tampon peut annuler une partie des gains logiciels.
Notre analyse
Ce retour montre que la performance d’une politique robotique dépend autant de la chaîne capteurs-calcul que du modèle. Une politique correcte dans le simulateur peut échouer sur le terrain à cause d’un tampon, d’un changement de caméra ou d’une différence d’éclairage difficile à voir dans les scores habituels.
Les résultats restent ceux de l’entreprise et devront être reproduits sur d’autres robots. La publication du code facilite toutefois cette vérification et fournit des repères concrets sur la latence et la mémoire, deux obstacles immédiats au déploiement des modèles vision-langage-action sur du matériel accessible.
Sources : PrismaX ; dépôt prism-pi ; note sur la mémoire.