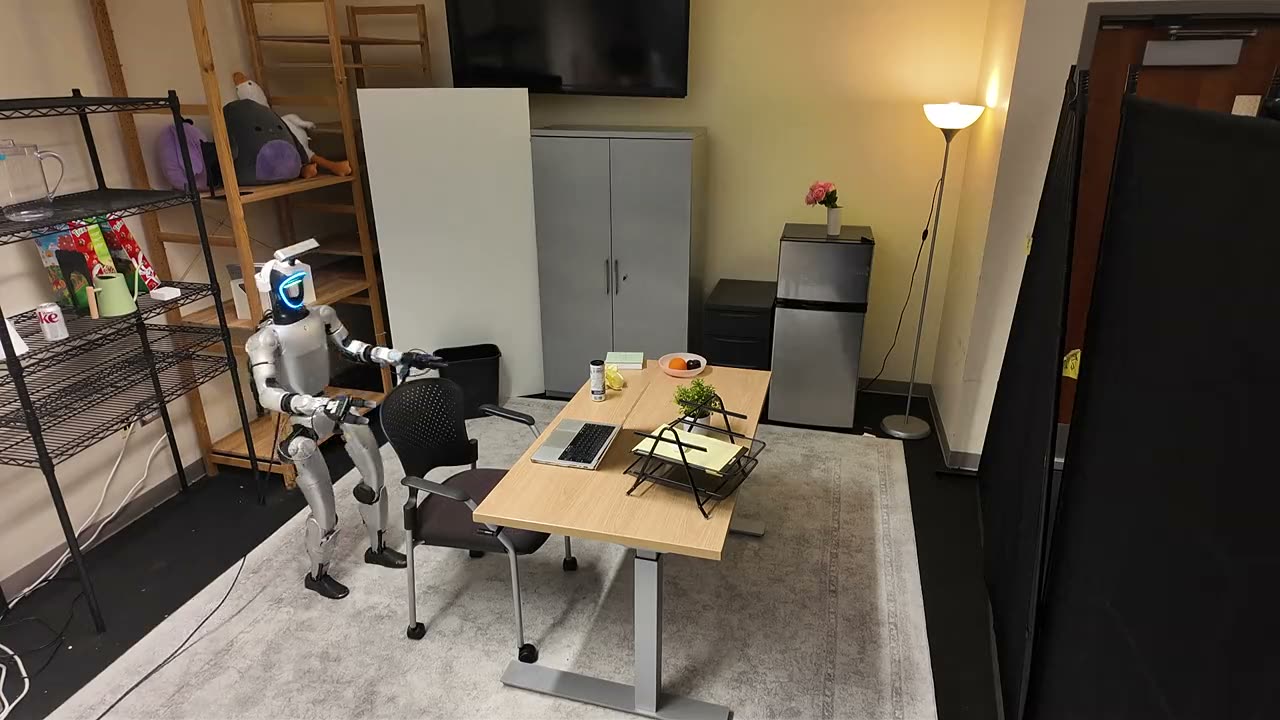
Maven Robotics et l’Université de Californie du Sud présentent Z-sight, un modèle de contrôle qui apprend à anticiper l’évolution visuelle d’une scène sans générer les images d’une vidéo. Testé sur un humanoïde Unitree G1, il atteint 73,3 % de réussite moyenne sur six tâches physiques.
Les modèles vision-langage-action transforment généralement une consigne et des images en commandes motrices. Z-sight ajoute une étape de prévision : il estime ce que les représentations visuelles internes du modèle devraient devenir après le mouvement, puis utilise cette estimation pour choisir les actions.
Prédire des représentations plutôt que des pixels
Les modèles dits « world action models » peuvent produire des images futures en parallèle des actions. Cette méthode aide le robot à raisonner sur les conséquences d’un geste, mais la génération vidéo demande beaucoup de calcul. Z-sight évite cette opération. Il prédit directement de futurs jetons visuels dans l’espace de représentation de son propre modèle.
L’architecture rassemble un modèle vision-langage Qwen3.5 de deux milliards de paramètres et deux modules de 480 millions de paramètres. Le premier prédit les états visuels futurs, le second génère une séquence de 30 actions. Les deux progressent ensemble pendant dix étapes de calcul, afin que la commande motrice puisse exploiter la prévision en cours de formation.
Les chercheurs ont entraîné l’ensemble sur 4 731 heures de vidéos humaines et de trajectoires robotiques. La phase finale utilise des démonstrations adaptées au robot cible. Cette quantité rappelle que le résultat dépend autant de la qualité des données que de l’architecture elle-même.
Six tâches sur un Unitree G1 réel
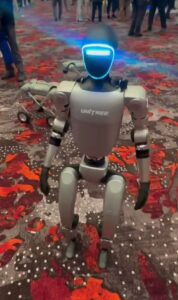
L’équipe a installé Z-sight sur un Unitree G1 doté de deux mains à sept degrés de liberté et d’une caméra placée sur la tête. Le robot devait réaliser six tâches, du déplacement d’objets sur une table à des séquences combinant marche, flexion du torse, ouverture d’un appareil et rangement.
Sur dix essais par tâche, Z-sight obtient 73,3 % de réussite moyenne. Le meilleur système de comparaison, Fast-WAM, atteint 53,3 %. L’écart annoncé de 20 points est surtout visible sur les opérations en plusieurs étapes, où les modèles sans prévision explicite ont tendance à s’arrêter après un premier sous-objectif.
En simulation, le modèle atteint 81,9 % sur le benchmark humanoïde SIMPLE, contre 72,3 % pour GR00T N1.7. Les auteurs mesurent aussi 109,5 millisecondes pour produire trois secondes de commandes sur une carte RTX 4090.
Des résultats prometteurs à confirmer
L’étude est une prépublication et ses résultats n’ont pas encore été reproduits indépendamment. Dix essais par tâche restent un échantillon limité pour juger la robustesse d’un robot dans un atelier ou un logement. Le protocole utilise aussi des configurations initiales appariées, plus contrôlées qu’un environnement de production.
L’apport de Z-sight est néanmoins concret : donner au contrôleur une forme d’anticipation sans supporter le coût d’une génération vidéo complète. La prochaine étape sera de vérifier si cet avantage subsiste avec des objets inconnus, des perturbations et des séquences plus longues.
La page officielle du projet rassemble les démonstrations vidéo sur le G1, les résultats détaillés et le code. L’article scientifique est disponible sur arXiv.