Une évaluation publiée par Fig montre qu’aucun modèle d’IA ne domine toutes les tâches agentiques testées, de la navigation web à la manipulation robotique. Même le modèle le mieux classé échoue sur des exercices réussis par des concurrents moins bien notés en moyenne.
L’équipe a comparé sept modèles sur 177 tâches de VisualWebArena, puis trois modèles sur quatre ensembles liés au monde physique : conduite autonome, manipulation, assemblage et procédures industrielles. Elle publie aussi RIDGE, un jeu de données regroupant les résultats au niveau de chaque tâche et les sorties des modèles.
Une moyenne ne décrit pas les compétences
Sur VisualWebArena, GPT-6 Astra termine en tête avec 139 réussites sur 177, soit 78,5 %. Fable 5 suit à 78 %, puis GPT-5.6 à 70,6 % et Claude Opus 5.5 à 70,1 %. L’écart entre les deux premiers reste inférieur à la bande de bruit de trois points retenue par les auteurs.
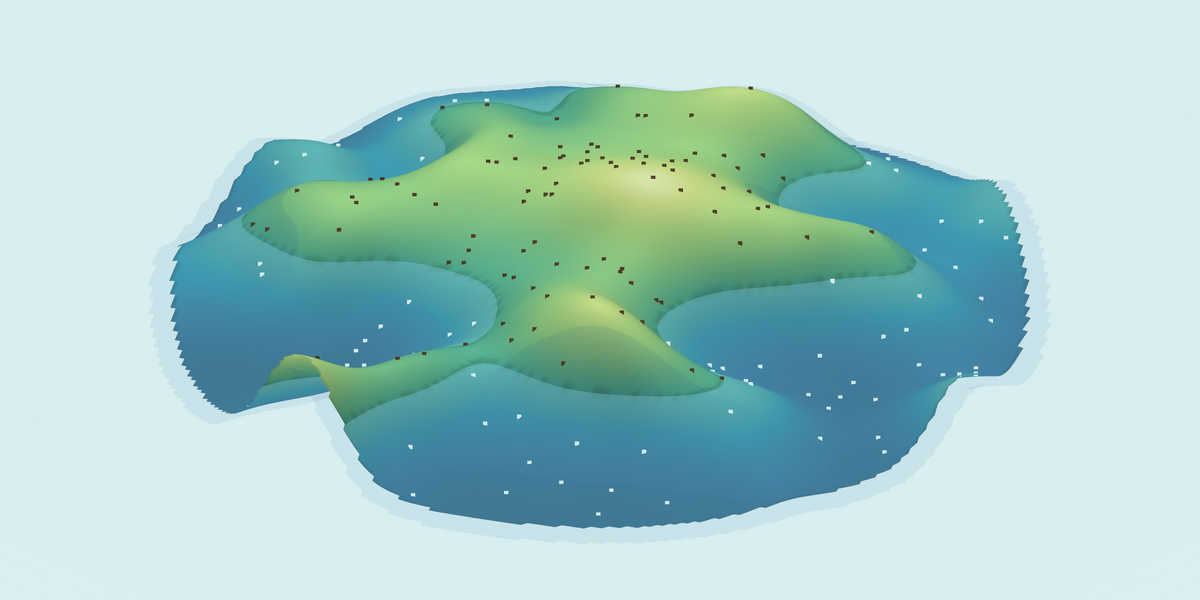
Le classement global masque surtout des profils très différents. Pour chacune des 21 paires de modèles, le moins bien classé réussit au moins trois tâches ratées par son concurrent. Sur l’ensemble du test, les sept modèles réussissent tous 66 tâches et échouent tous sur 21. Les 90 autres, soit 51 % du total, déterminent l’essentiel du classement.
Les performances changent également selon le site. Astra atteint 91 % sur les tâches inspirées de Reddit, contre 77 % sur les petites annonces et 73 % sur le commerce en ligne. Fable 5 prend l’avantage sur les petites annonces avec 85 %. Choisir un modèle sur sa seule moyenne peut donc conduire à retenir le mauvais outil pour un produit précis.
Les mises à jour déplacent les points faibles
Le passage de Claude Opus 4.7 à Opus 5 illustre ce risque. La moyenne baisse seulement de 1,1 point, mais 36 tâches changent de résultat : 17 deviennent réussies et 19 échouent. L’effet varie même selon le site, avec une amélioration sur les achats et une baisse sur Reddit et les petites annonces.
GPT-6 Astra améliore de 7,9 points la moyenne de GPT-5.6, tout en régressant sur deux des 21 catégories étudiées. Opus 5.5 gagne 5,1 points par rapport à Opus 5 et ne perd aucune catégorie agrégée, mais échoue encore sur 11 tâches que son prédécesseur réussissait.
Le même phénomène dans les tâches physiques
Astra et Opus 5.5 dépassent Gemini 3.5 Flash sur la moyenne des quatre domaines physiques. Astra fait notamment passer le score d’IndEgo de 0,377 à 0,587 et celui de VLABench de 0,740 à 0,925. Pourtant, Astra reste moins performant sur 16 des 185 catégories détaillées, et Opus 5.5 sur 26.
Les auteurs soulignent plusieurs limites. Chaque configuration n’a été exécutée qu’une fois, les interfaces d’outils diffèrent selon les modèles et certains vérificateurs automatiques classent mal des réponses pourtant valides. Le travail mesure donc la forme des écarts, pas leur cause.
Notre analyse
Cette étude rappelle qu’un agent doit être évalué sur les tâches qu’il accomplira réellement. Une moyenne de benchmark est utile pour suivre une tendance, mais insuffisante pour décider d’un déploiement. Les équipes ont besoin d’un profil de compétences par catégorie et doivent le recalculer après chaque changement de modèle ou de prompt.