OpenAI et la société de biotechnologie Ligo lancent BioBasicsBench, un benchmark de 100 tâches conçu pour mesurer la capacité des agents IA à interpréter les données brutes d’expériences de laboratoire.
Présenté le 6 novembre, le test s’intéresse aux analyses courantes de biologie expérimentale. Il ne demande pas seulement de restituer des connaissances : les agents doivent lire des preuves produites par des instruments, choisir une méthode et justifier une conclusion à partir de données imparfaites.
Cent tâches issues d’expériences réelles
BioBasicsBench couvre cinq familles : protéines, imagerie et cytométrie, tests et quantification, acides nucléiques, ainsi que clonage. Les entrées comprennent des images, des vidéos et des fichiers d’instruments. Cette variété oblige un système à extraire l’information pertinente avant de raisonner.
Le benchmark a été développé avec Ligo, une entreprise spécialisée dans la conception d’enzymes. OpenAI indique que les 100 tâches proviennent d’expériences réelles et représentent des opérations récurrentes du travail en laboratoire.
Cette construction répond à une limite des évaluations fondées sur des questions textuelles. Un modèle peut connaître la définition d’une technique sans savoir reconnaître une anomalie dans une image, interpréter une courbe ou relier un résultat à la bonne étape d’un protocole.
Évaluer l’analyse, pas l’automatisation physique
BioBasicsBench ne pilote pas directement des pipettes ni des automates. Il mesure la couche d’analyse qui intervient après la collecte des données. Un bon score ne prouve donc pas qu’un agent peut conduire seul une expérience complète, gérer la sécurité biologique ou détecter tous les défauts d’un protocole.
Cette séparation est importante. Dans un laboratoire, une erreur d’interprétation peut conduire à répéter des essais, écarter une hypothèse utile ou engager des ressources sur une mauvaise piste. Le benchmark cherche à rendre ces erreurs visibles sur des cas plus proches du quotidien scientifique.
Des résultats à lire avec prudence
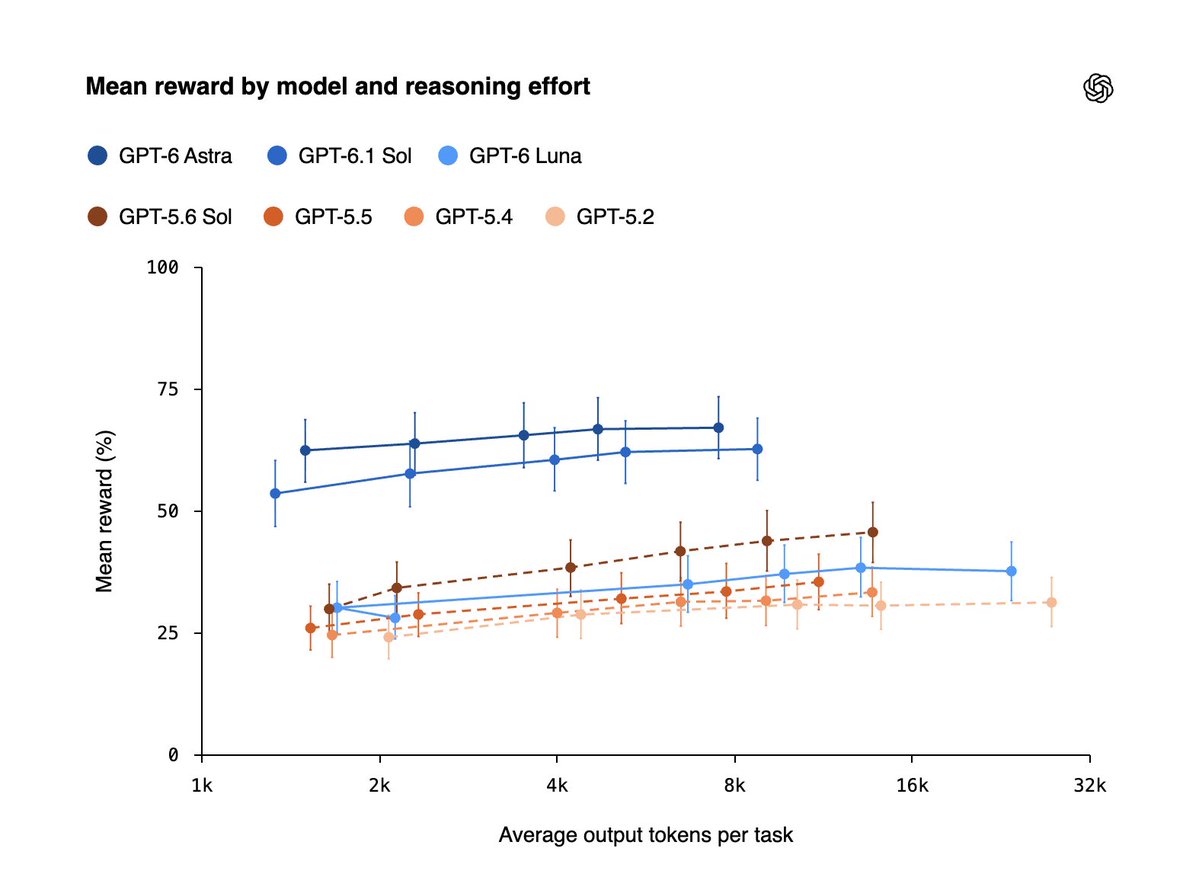
OpenAI présente BioBasicsBench comme une nouvelle manière de comparer les agents. La portée réelle dépendra de la publication détaillée des données, des critères de notation et des résultats par domaine. Les tâches devront aussi éviter que les réponses puissent être déduites par des indices de forme.
La collaboration avec une entreprise de biotechnologie apporte un ancrage pratique, mais une évaluation indépendante restera nécessaire. Les laboratoires n’utilisent pas tous les mêmes instruments, formats ni procédures. Un agent performant sur un corpus donné peut perdre en fiabilité face à un appareil différent ou à des données plus bruitées.
Un jalon pour les agents scientifiques
Les éditeurs d’IA multiplient les outils destinés à la recherche, depuis la lecture d’articles jusqu’à la proposition d’hypothèses. BioBasicsBench déplace l’attention vers une étape moins visible : transformer les sorties concrètes d’une expérience en conclusion exploitable.
Pour les équipes scientifiques, l’intérêt ne sera pas de remplacer la validation humaine, mais de disposer d’une mesure commune avant d’intégrer un agent dans un flux de travail. Un test public et reproductible peut aider à repérer les domaines où l’assistance est utile et ceux où les erreurs restent trop fréquentes.
La prochaine étape sera de suivre l’accès aux tâches, les performances détaillées des modèles et la résistance du test aux nouveaux agents. Avec ces éléments, BioBasicsBench pourrait devenir un point de comparaison utile pour l’IA appliquée au laboratoire.
Sources : OpenAI, publication officielle sur X et AlphaSignal.