OpenAI affirme que ses modèles ont permis d’améliorer des circuits déjà fortement optimisés chez AMD et sur sa propre puce d’inférence Jalapeño. L’entreprise annonce jusqu’à 14 % de gains sur des critères combinant puissance, performances et surface, tandis que certaines modifications ont déjà été intégrées à des conceptions destinées à la fabrication.
Des changements appliqués à des puces de production
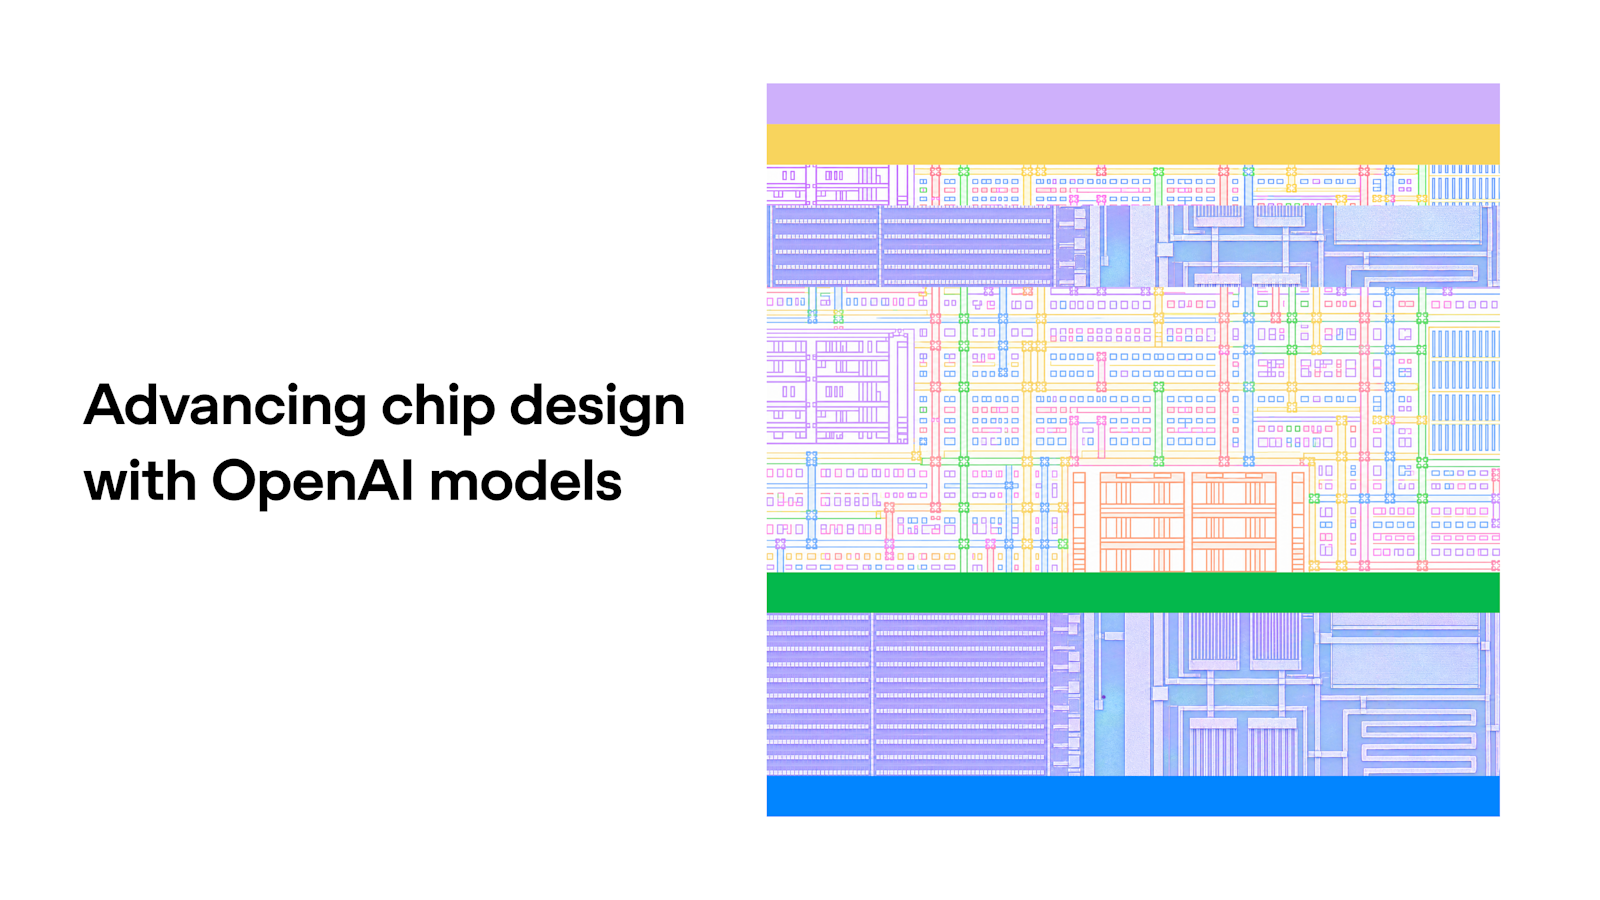
Dans un bilan technique publié le 18 novembre, OpenAI détaille l’usage de ses modèles pour réécrire du code SystemVerilog, le langage qui décrit le fonctionnement des circuits. Les propositions sont ensuite vérifiées avec des outils de conception électronique afin de s’assurer qu’elles conservent le comportement attendu.
Sur Jalapeño, sa première puce d’inférence personnalisée, OpenAI estime que les changements proposés ont réduit d’environ 13 % la surface occupée par les cellules standard dans l’unité vectorielle et de 10 % dans l’unité matricielle. Un multiplicateur et un additionneur auraient chacun gagné environ 15 % de surface. Ces optimisations ont été validées sur le silicium lors de la mise en route de la puce.
Le travail mené avec AMD va plus loin. OpenAI évoque jusqu’à 14 % d’amélioration face à des bases déjà optimisées sur une propriété intellectuelle de GPU haut de gamme. Selon l’entreprise, ce résultat représente environ un an de progrès obtenu en moins de cinq mois. AMD aurait intégré certains changements dans une conception récemment envoyée en fabrication et conservé d’autres modifications pour de futures générations. Des gains à un chiffre ont aussi été vérifiés sur des blocs d’un prochain processeur phare.
GPT-6.2 Astra testé sur des cœurs RISC-V
Pour comparer plusieurs générations de modèles, OpenAI a également utilisé deux processeurs open source de 32 bits, PicoRV32 et Ibex. Les modèles devaient soit améliorer un cœur existant, soit en concevoir un à partir d’exigences écrites. Les résultats étaient rejetés si les tests de correction échouaient ou si la surface dépassait seize fois celle du circuit de départ.
À budget comparable d’environ 112 000 jetons par essai, GPT-6.2 Astra obtient le meilleur score moyen sur les deux cœurs. Sur PicoRV32, son résultat annoncé atteint environ le double de celui de GPT-6 Astra. L’évaluation complète couvre 9 881 exécutions, mais elle reste un banc d’essai. OpenAI reconnaît que des contraintes plus strictes sur les fonctions obligatoires, la surface et le minutage après synthèse physique rendraient la comparaison plus proche d’un projet industriel complet.
Un modèle spécialisé avec Synopsys
OpenAI prépare aussi GPT-Synopsys, un modèle entraîné pour utiliser les outils d’automatisation de la conception électronique de Synopsys comme le ferait un ingénieur. L’objectif est de relier les capacités de raisonnement des modèles aux vérifications indispensables avant toute fabrication.
L’annonce ne signifie pas que la conception d’une puce devient autonome. Les résultats décrits reposent sur des équipes humaines, des outils de validation spécialisés et des contrôles successifs. Ils montrent néanmoins que l’IA générative commence à intervenir sur des composants industriels réels, au-delà de la simple production de code logiciel. Si les chiffres annoncés se confirment sur d’autres architectures, le principal effet pourrait être une exploration plus rapide des compromis entre vitesse, consommation et surface.
Notre analyse
Le point le plus solide n’est pas le score obtenu sur RISC-V, mais l’intégration de modifications dans des conceptions AMD et dans une puce déjà produite. La conception électronique exige une précision extrême, et un gain de quelques pourcents peut avoir une valeur économique importante. La prudence reste nécessaire, car les données sont publiées par OpenAI et ne constituent pas une évaluation indépendante. La collaboration avec AMD et Synopsys donne toutefois à cette démonstration une portée industrielle inhabituelle.