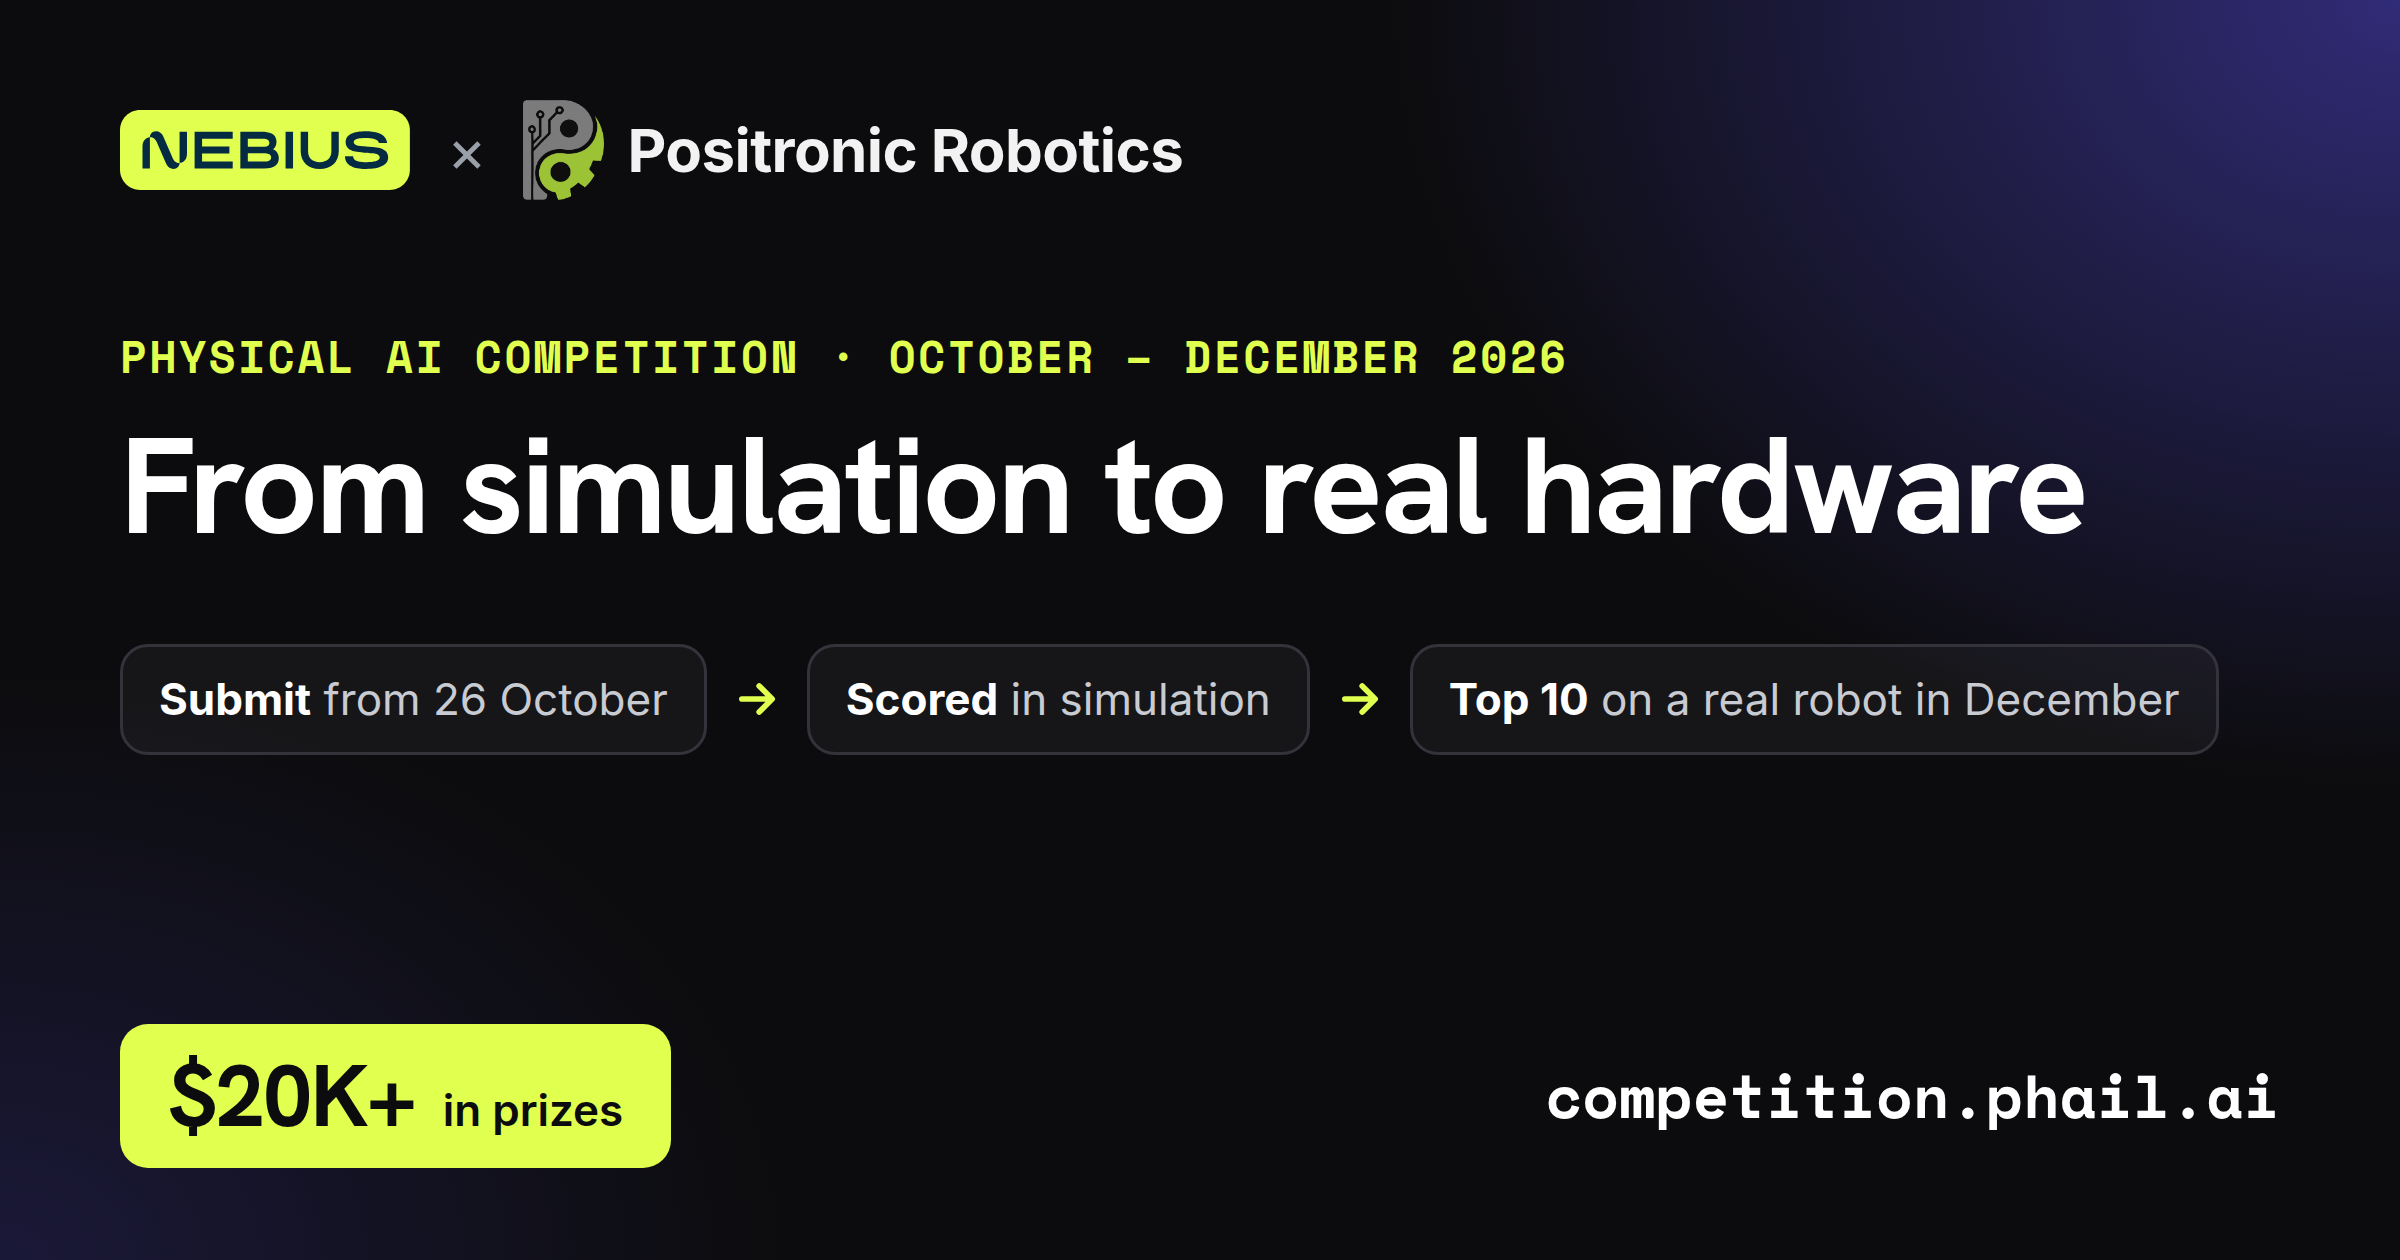
PhAIL et Nebius ouvrent une compétition destinée à mesurer le passage des politiques robotiques de la simulation au monde réel. Les participants soumettent un même conteneur logiciel, évalué dans deux simulateurs avant que les dix meilleurs systèmes ne soient testés en décembre sur un bras Franka.
La compétition prolonge le benchmark PhAIL lancé au printemps pour comparer des modèles vision-langage-action sur du matériel réel. Cette fois, l’objectif est d’observer si un bon score en simulation prédit réellement la capacité d’un robot à manipuler des objets physiques sans adaptation de dernière minute.
Deux simulateurs avant le verdict du robot
Les politiques sont d’abord classées dans MolmoSpaces. Un second environnement, RoboLab, doit rejoindre l’évaluation à partir du 16 novembre. Les candidats les mieux placés seront ensuite exécutés sur un Franka avec des tâches proches du benchmark DROID, mais sur un jeu différent de celui utilisé pendant les phases simulées.
Le même conteneur Docker doit servir dans les trois environnements. PhAIL s’appuie sur Positronic, son cadre logiciel ouvert qui expose une interface commune aux simulateurs et au robot. L’organisation prévoit aussi d’exécuter chaque semaine certaines politiques sur le matériel réel afin de fournir des retours avant la finale.
La latence et la mémoire comptent dans le classement
La compétition limite chaque politique à 24 Go de mémoire, une capacité comparable à celle d’une GeForce RTX 4090. Cette contrainte exclut certains modèles plus lourds dans leur configuration habituelle et oblige les équipes à optimiser leur déploiement.
Le temps de calcul n’est pas neutralisé. L’horloge du simulateur continue d’avancer pendant que le modèle prépare son action, comme un robot réel qui ne peut pas figer son environnement. Des exemples sont proposés pour π0.5, GR00T N1.7 et MolmoAct2. L’infrastructure doit aussi accueillir des politiques capables de raisonner plus longtemps, à condition qu’elles terminent la tâche dans le délai imparti.
Les récompenses atteignent 23 500 dollars sous forme de crédits GPU et d’évaluation Nebius. Une enveloppe de 1 000 dollars est réservée au meilleur compte rendu publié en open source.
Un test utile, mais pas encore un résultat
Le signal éditorial est l’ouverture de la compétition, pas la victoire d’un modèle. Les résultats sur Franka ne seront disponibles qu’en décembre. La sélection finale devra donc être examinée séparément, notamment pour vérifier que les équipes n’ont pas optimisé leurs systèmes sur des indices propres aux simulateurs.
Notre analyse
Le protocole s’attaque à un défaut récurrent des évaluations robotiques : une politique peut apprendre les particularités d’un simulateur et s’effondrer au premier changement d’éclairage, de friction ou de position d’objet. Imposer deux simulations puis un test réel réduit ce risque sans le supprimer.
L’autre intérêt vient de la reproductibilité. Une image Docker unique et une API commune rendent les comparaisons plus lisibles que des démonstrations préparées séparément par chaque laboratoire. La valeur du concours dépendra toutefois de la transparence des tâches, des échecs et des vidéos complètes de la finale.
Sources : PhAIL Competition ; cadre Positronic.