Reka a présenté Rho-1, un modèle de 19 milliards de paramètres qui traite dans un même réseau le texte, les images, la vidéo et les actions robotiques. Cette préversion de recherche cherche à réunir perception, génération et commande sans passer par une chaîne de modèles spécialisés.
L’entreprise californienne affirme avoir entraîné Rho-1 à partir de zéro sur 320 GPU Nvidia H100 pendant environ trois mois. Le modèle place les différentes modalités dans une fenêtre de contexte partagée. Une même conversation peut ainsi partir d’une consigne écrite, produire une image, l’animer, modifier la vidéo puis générer des commandes destinées à un robot.
Un même modèle pour prévoir et agir
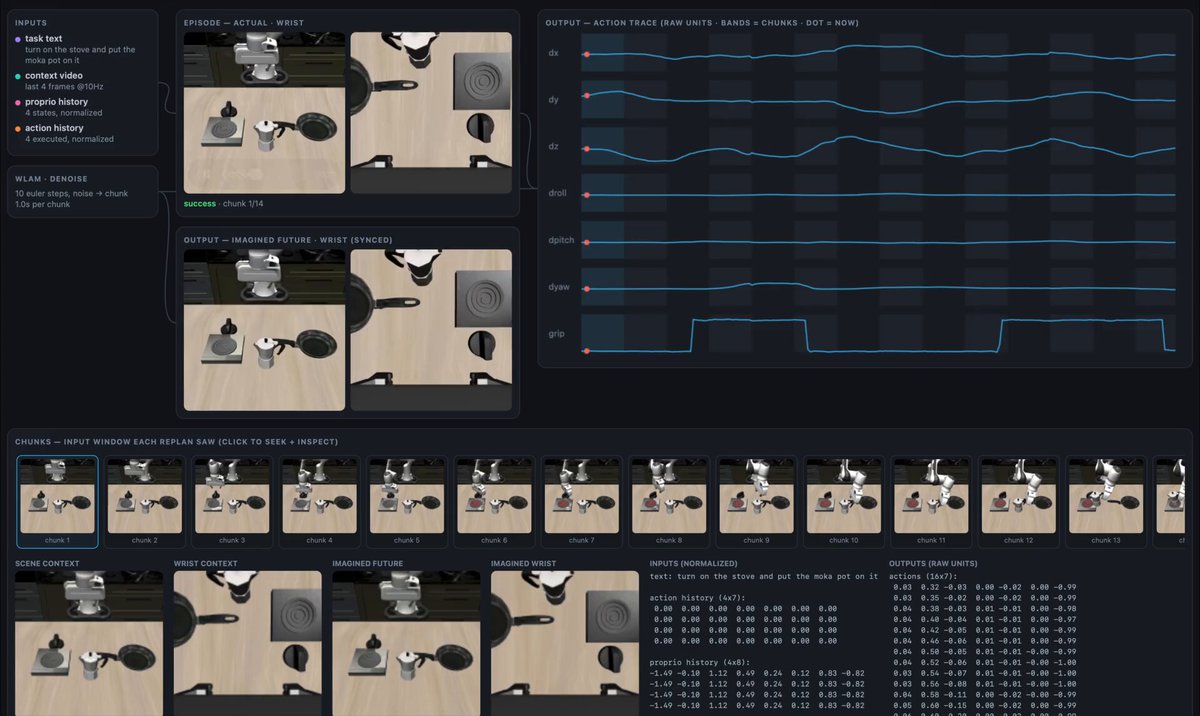
La partie robotique constitue l’aspect le plus concret de l’annonce. Selon Reka, les mêmes poids qui prédisent l’image suivante d’une caméra servent aussi à produire des mouvements articulaires. L’objectif est d’éviter un montage dans lequel un modèle de perception transmet ses résultats à un planificateur, puis à un contrôleur indépendant.
Pour compenser la rareté des données enregistrées sur de vrais robots, Reka dit avoir développé un modèle de dynamique inverse. Celui-ci extrait des signaux de contrôle à partir de vidéos ordinaires disponibles sur internet. Cette méthode doit permettre d’apprendre une relation entre les changements visibles d’une scène et les actions qui ont pu les provoquer.
Reka montre comment Rho-1 relie prédiction visuelle et commande robotique.
— Reka (@RekaAILabs) 5 octobre 2026
Rho-1 est aussi présenté comme un modèle de monde pilotable. Il génère une séquence vidéo en continu et peut changer sa trajectoire lorsqu’une nouvelle instruction arrive, sans recommencer le rendu depuis le début. Cette continuité intéresse la simulation robotique, où le système doit conserver l’état d’une scène pendant qu’un agent agit.
Une préversion sans preuve de déploiement
L’annonce reste toutefois celle d’un prototype de recherche. Reka ne fournit pas de benchmark détaillé sur des tâches robotiques standardisées, ni de taux de réussite sur du matériel physique. Elle ne précise pas non plus quels bras ou plateformes ont été utilisés, combien d’essais ont été réalisés ou comment la sécurité des mouvements est contrôlée.
Les démonstrations publiées illustrent une architecture, mais elles ne suffisent pas à mesurer sa robustesse. Un modèle peut produire une vidéo convaincante tout en déplaçant progressivement des objets, en modifiant la géométrie d’une pièce ou en accumulant des erreurs. Pour commander un robot, ces dérives visuelles deviennent des erreurs de position potentiellement matérielles.
Notre analyse
Rho-1 propose une direction importante pour l’IA incarnée : apprendre dans un espace commun ce que le robot voit, ce qui va se passer et l’action à entreprendre. Si cette approche réduit les interfaces entre plusieurs modèles, elle peut simplifier l’entraînement et améliorer la cohérence entre perception et mouvement.
Le passage au terrain sera néanmoins le véritable test. Il faudra comparer le modèle à des systèmes spécialisés sur la précision, la latence, la consommation de calcul et la capacité à arrêter une action dangereuse. Les résultats devront aussi distinguer ce qui vient des vidéos internet de ce qui exige encore des données collectées sur le robot cible. Rho-1 ouvre donc une piste crédible, mais Reka doit encore démontrer qu’un réseau multimodal unique peut conserver sa cohérence au contact du monde réel.
Sources : annonce officielle de Reka, 5 octobre 2026 ; The Decoder, 5 octobre 2026.