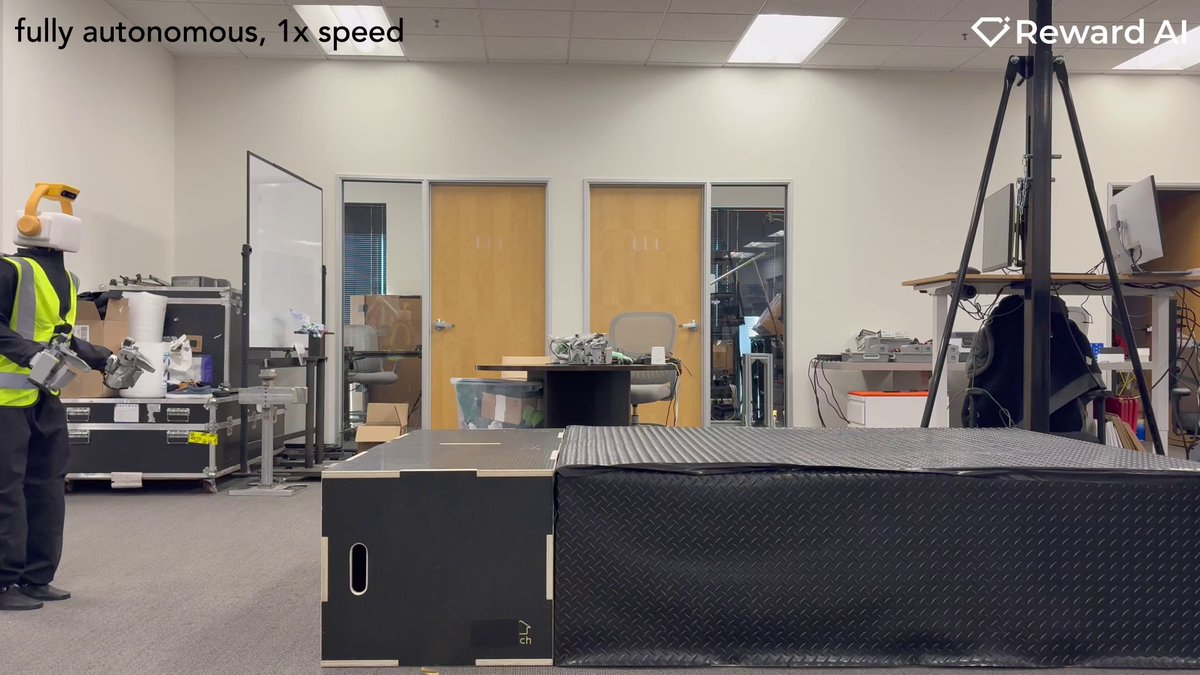
Reward AI a publié le 27 octobre une nouvelle démonstration de son modèle robotique OM-1. Des humanoïdes y manipulent des colis en intérieur et en extérieur, récupèrent un paquet dans un véhicule et travaillent près d’escaliers. L’entreprise présente ces séquences comme entièrement autonomes et exécutées à vitesse réelle.
La vidéo montre notamment un robot qui adapte son approche à la position et à l’orientation d’un colis, le saisit puis se déplace avec la charge. Reward AI veut démontrer que la même politique peut piloter plusieurs corps robotiques sans repartir d’un apprentissage propre à chaque machine.
Reward AI teste OM-1 sur la livraison et la manipulation près d’escaliers.
— Reward AI (@RewardAI_) October 27, 2026
Un modèle entraîné à partir de gestes humains
OM-1 est le cœur de la pile Omnibody présentée par Reward AI en septembre. Son principe consiste à apprendre directement à partir de personnes équipées d’un dispositif de capture, et non à partir d’un robot téléopéré. L’entreprise affirme ne pas utiliser de données collectées sur un robot pour entraîner cette politique générale.
Le dispositif Omnibody Hand possède sept degrés de liberté. Il mesure les mouvements de la main, les contacts, la proximité entre les doigts et les efforts appliqués. Des caméras à obturateur global conservent le contexte visuel pendant les gestes rapides. Reward AI associe aussi un suivi électromagnétique au suivi visuel et inertiel. Dans son essai interne le plus rapide, l’erreur moyenne de dépassement passe de 24,9 à 9,5 mm.
Ces données alimentent ensuite une interface commune. OM-1 reçoit séparément les images, les signaux tactiles, la proximité et la trajectoire de la main, à la fréquence native de chaque capteur. Il produit des consignes de direction, de vitesse, de force et de prise. Une couche de contrôle entraînée en simulation traduit ces consignes pour le robot utilisé et compense les délais ou les charges imprévues.
De la manipulation à la livraison
La nouvelle démonstration étend la présentation initiale vers des tâches plus mobiles. Saisir un carton dans un coffre puis le transporter oblige le système à combiner perception, manipulation et équilibre. Près d’un escalier, une mauvaise estimation de la charge ou du contact peut déstabiliser le robot. Reward AI affirme que son contrôleur continue de fonctionner pendant que le modèle calcule l’action suivante afin d’éviter les arrêts dans le mouvement.
L’entreprise indique aussi qu’une tâche nouvelle peut être acquise avec moins de trente minutes de démonstrations humaines. Si cette propriété se confirme sur des évaluations indépendantes, elle réduirait le coût de collecte des données pour chaque robot et chaque usage.
Une démonstration encore contrôlée par son auteur
Les images restent une communication du fabricant. Reward AI ne fournit pas, avec cette vidéo, de taux de réussite, de nombre d’essais, de comparaison avec d’autres politiques ni d’évaluation sur un site client. La séquence montre donc une capacité, pas encore une fiabilité industrielle ou commerciale.
Le point à suivre sera la répétabilité dans des environnements moins préparés : météo, éclairage, formes de colis, obstacles et escaliers différents. Il faudra aussi mesurer la fréquence des interventions humaines. La promesse d’une politique commune à plusieurs robots est forte, mais sa valeur dépendra du maintien des performances lorsque les corps, les capteurs et les conditions changent.
Sources : démonstration officielle Reward AI et présentation technique d’OM-1.