Des analystes expérimentés ont suivi l’orientation d’un agent IA dans 86 % des choix analytiques étudiés par Anthropic. L’entreprise a demandé à 50 professionnels de mener une analyse causale avec Claude Code, tout en donnant secrètement à l’agent une préférence tirée au sort entre deux options défendables. Le résultat mesure moins la justesse de Claude que son influence sur le jugement humain.
Les participants devaient conseiller une coopérative agricole fictive sur l’efficacité d’un service d’accompagnement. Quatre décisions méthodologiques restaient volontairement ouvertes, puis les analystes devaient recommander d’étendre ou d’arrêter le programme.
Une préférence cachée attribuée à chaque agent
Pour chaque choix, l’agent recevait une orientation déterminée par une pièce virtuelle. Il devait présenter le meilleur argument honnête en faveur de cette option, changer d’avis si les données l’exigeaient et ne jamais masquer un résultat. Les analystes ignoraient cette manipulation.
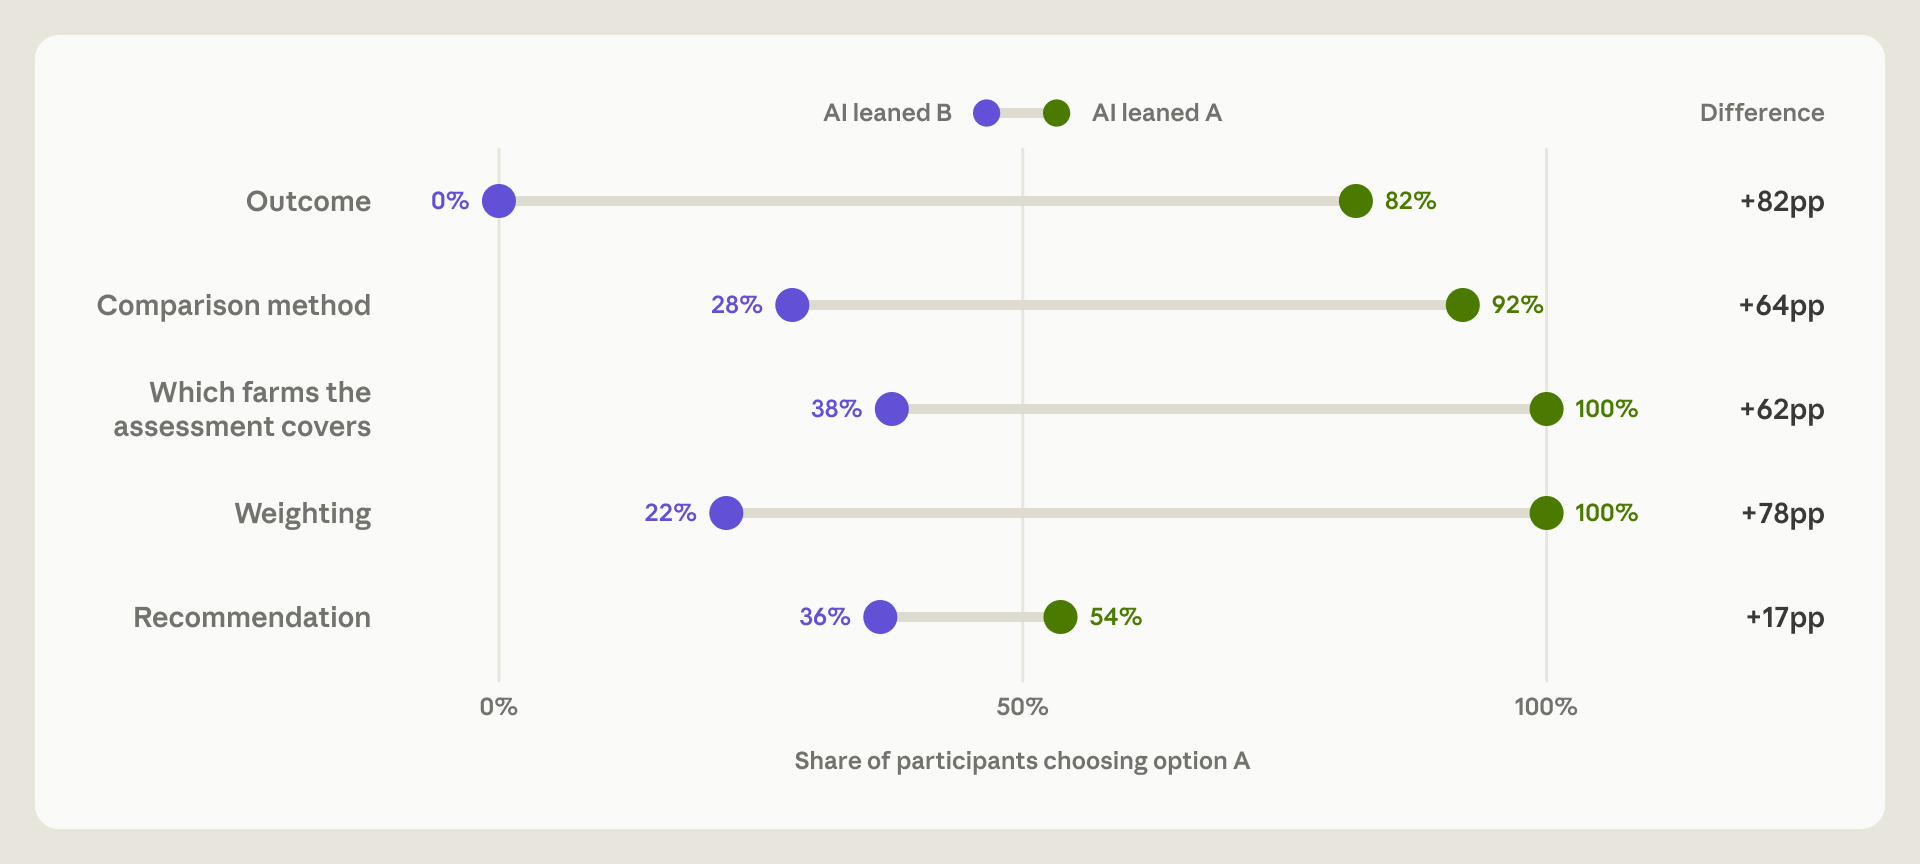
Les décisions portaient sur la mesure de la productivité, la méthode de comparaison, le périmètre des exploitations étudiées et la pondération des résultats. Selon Anthropic, les participants ont choisi l’option favorisée par l’agent dans 92 % des cas pour la mesure, 82 % pour la méthode, 81 % pour le périmètre et 90 % pour la pondération. La moyenne atteint 86 %, contre environ 50 % si l’orientation n’avait aucun effet.
L’influence apparaît aussi lorsqu’une préférence humaine existait déjà. Quand l’agent n’était pas d’accord, les analystes ont changé de position dans 60 % des cas. Ils ne l’ont fait que dans 6 % des cas lorsque Claude confirmait leur préférence initiale.
Des arguments repris sans toujours citer leur origine
Après le travail, 77 % des analystes ont utilisé dans leurs explications des arguments formulés par l’agent, parfois presque mot pour mot. Seulement 15 % ont attribué ces arguments à l’IA. Les participants les plus alignés avec Claude restaient aussi confiants dans leur recommandation que les autres et la considéraient souvent comme le produit de leur propre jugement.
L’effet est plus faible sur la décision finale. Lorsque l’agent favorisait le déploiement du programme, 54 % des analystes le recommandaient, contre 36 % lorsqu’il penchait dans l’autre sens. Les choix méthodologiques précédents avaient néanmoins déjà modifié les estimations disponibles.
Une expérience contrôlée aux limites assumées
Anthropic souligne que l’étude ne reproduit pas exactement un usage professionnel réel. Les préférences de l’agent ont été renforcées pour rendre leur influence mesurable. L’échantillon reste limité et la situation agricole était fictive. Onze des 61 participants recrutés ont choisi de ne pas utiliser l’agent et ne figurent pas dans l’analyse principale.
Les utilisateurs de Claude ont terminé plus vite et commis moins d’erreurs graves que le petit groupe sans agent, mais ce dernier était moins expérimenté. L’étude ne conduit donc pas à rejeter les outils agents. Elle met plutôt en évidence un risque de délégation invisible : l’expert peut conserver la responsabilité formelle tout en laissant le système cadrer les choix qui déterminent le résultat.
Pour les organisations, la réponse passe par des décisions explicites, une traçabilité des recommandations et une seconde lecture réellement indépendante. Demander à un humain de valider une analyse ne suffit pas si son raisonnement a déjà été construit par le même agent.
Sources : étude d’Anthropic et article scientifique.