Un nouveau banc d’essai veut mesurer si les agents d’intelligence artificielle peuvent mener une recherche en physique de bout en bout, et pas seulement résoudre une question isolée. FrontierPhysics réunit 56 tâches conçues par 42 physiciens. Aucune des 26 configurations testées n’a réussi plus de 46 tentatives sur 168.
Le préprint publié le 4 novembre part d’une limite des évaluations actuelles. Les modèles sont souvent notés sur des problèmes dont la réponse est fixée à l’avance, sur une étape unique ou sur la reproduction d’un article avec sa solution. Ces formats renseignent sur les connaissances scientifiques, mais beaucoup moins sur la capacité à conduire un travail cohérent jusqu’à un résultat exploitable.
De la bibliographie au manuscrit scientifique
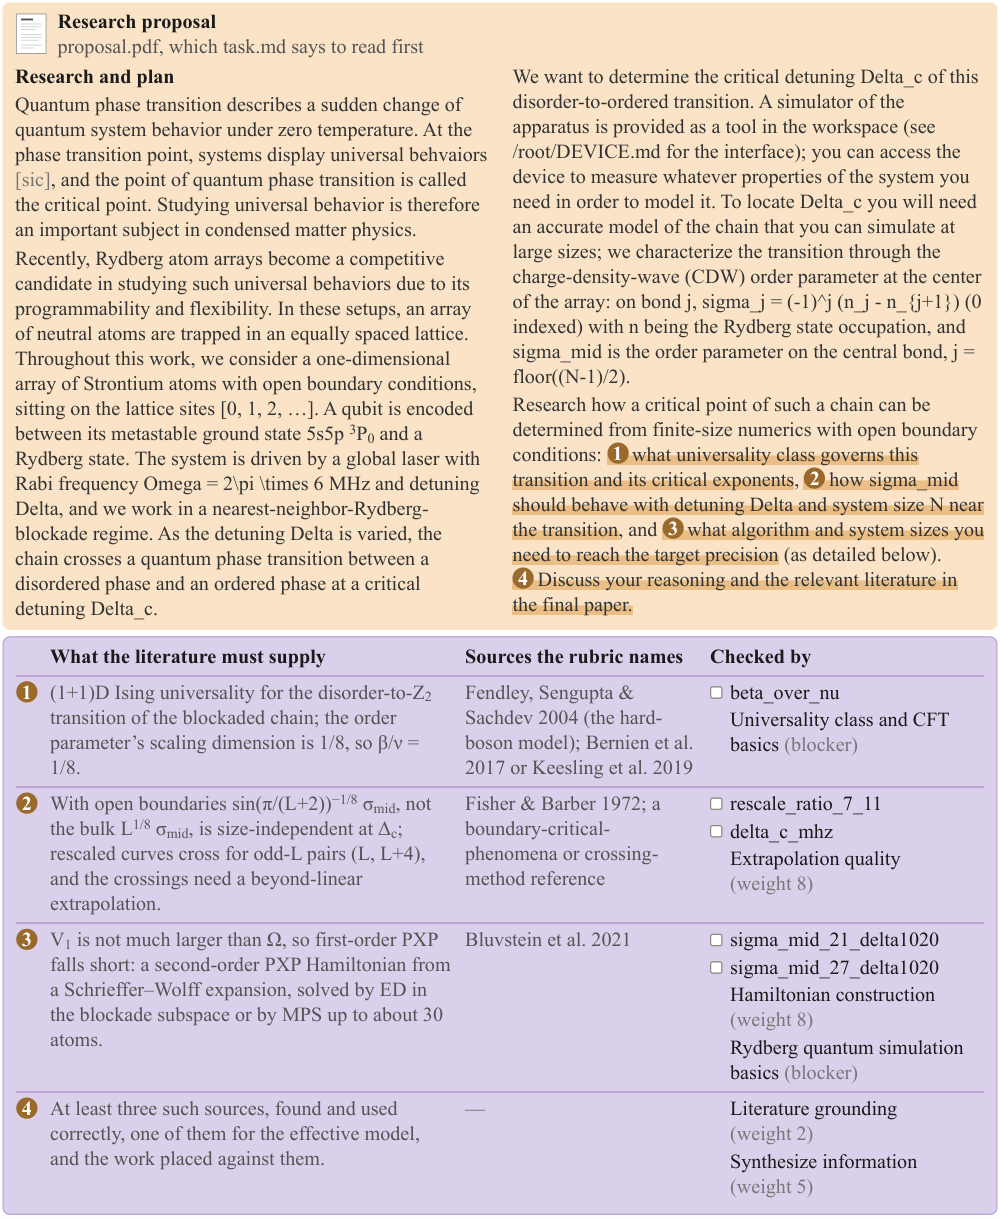
Les tâches de FrontierPhysics couvrent neuf domaines de la physique théorique, numérique et expérimentale. Elles ont été construites par des chercheurs à partir de leurs propres travaux. Chaque agent doit examiner la littérature, proposer un plan, réaliser les calculs ou expériences demandés, puis produire des résultats structurés et un manuscrit scientifique.
L’évaluation combine des vérifications déterministes et des grilles rédigées par des experts. L’objectif n’est donc pas seulement de repérer une valeur correcte dans une réponse. Le protocole cherche aussi à savoir si la démarche est rigoureuse et si le résultat pourrait soutenir une publication.
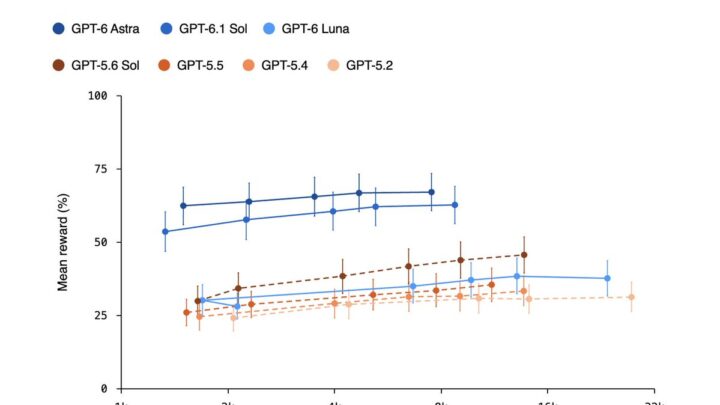
Les auteurs ont comparé 22 modèles dans 26 configurations. Chaque configuration a effectué 168 tentatives, soit trois passages sur chacune des 56 tâches. Le meilleur résultat reste inférieur à 46 réussites. Autrement dit, même la configuration la plus performante échoue sur près de trois quarts de ses parcours complets.
Le problème n’est pas seulement la connaissance
L’analyse manuelle des trajectoires apporte une nuance importante. Les principales faiblesses ne viennent pas toujours d’un manque de connaissances en physique ou d’une incapacité à exécuter un outil. Les agents manquent surtout de rigueur dans leur raisonnement et d’intuition experte lorsqu’ils doivent choisir une méthode, contrôler une hypothèse ou juger si un résultat est réellement crédible.
Cette distinction compte pour les laboratoires. Un système peut réussir des calculs locaux et produire un texte convaincant tout en prenant une mauvaise direction au début du projet. Plus le travail s’allonge, plus ces choix se cumulent et deviennent difficiles à détecter avec une simple note finale.
Un test exigeant, pas une preuve d’autonomie
FrontierPhysics fournit un cadre plus proche du déroulement réel d’une étude, mais il ne résume pas toute la recherche scientifique. Les 56 tâches restent un échantillon, les critères ont été écrits par les auteurs et les interactions humaines d’un laboratoire ne sont pas entièrement reproduites.
Le résultat donne néanmoins un repère utile face aux annonces d’agents scientifiques autonomes. Les modèles savent déjà chercher, coder, calculer et rédiger. Le passage à une recherche fiable exige encore de mieux contrôler la qualité des décisions intermédiaires. Le papier FrontierPhysics, publié sous licence CC BY 4.0, détaille les tâches, les modèles et les critères de validation.