Boden AI a mis en libre accès un jeu de données de 82,23 heures consacré aux moments où un opérateur humain reprend la main sur un robot domestique en difficulté. Publié sur Hugging Face sous licence CC BY 4.0, RW-RL-HIL rassemble 3 347 épisodes enregistrés pendant des déploiements réels du robot R1Lite.
Le corpus contient 4,44 millions d’images et représente 188,57 Go. Parmi les séquences conservées, 3 068 comprennent au moins une intervention humaine. Les 279 autres restent dans l’ensemble, mais peuvent être écartées grâce au champ has_intervention. Les données couvrent neuf tâches ménagères, comme nettoyer une table, plier des vêtements, verser de l’eau ou brancher un chargeur.
Apprendre précisément là où le robot échoue
L’intérêt de RW-RL-HIL tient moins au volume qu’à la nature des trajectoires. Un corpus d’imitation classique montre généralement au robot une exécution idéale depuis une situation propre. Ici, l’intervention commence lorsque la politique autonome atteint une situation qu’elle ne sait plus gérer. L’opérateur corrige alors le mouvement, puis rend le contrôle au système lorsqu’une reprise autonome devient possible.
Chaque séquence documente ainsi trois moments utiles : l’approche d’un échec, la correction depuis un état dégradé et le retour à l’autonomie. Selon la fiche officielle du jeu de données, ces transitions peuvent alimenter la détection d’échec, l’estimation d’incertitude, l’apprentissage de récupération ou l’évaluation de la valeur d’une action.
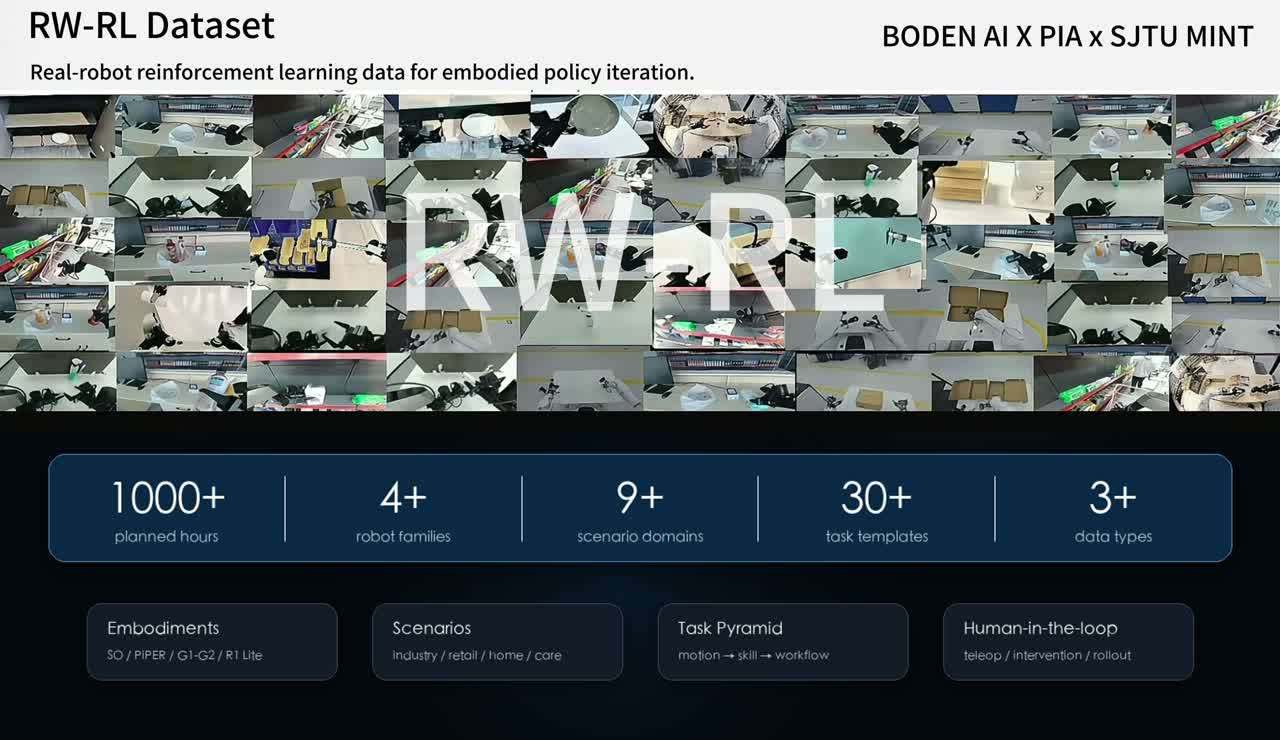
Le corpus n’est pas présenté comme un remplacement de RW-RL, le jeu de données principal publié avec le centre d’innovation JIP et le laboratoire MINT de l’université Jiao Tong de Shanghai. Il en constitue un sous-ensemble spécialisé, destiné à être combiné avec les démonstrations téléopérées et les trajectoires autonomes déjà disponibles.
Un jeu de données ancré dans le déploiement réel
La différence est importante pour la robotique domestique. Les erreurs qui comptent apparaissent souvent après plusieurs actions, face à un objet déplacé, un mauvais angle de prise ou un contact imprévu. Des démonstrations parfaitement exécutées décrivent mal ces états hors distribution. Les reprises humaines enregistrées pendant l’usage capturent au contraire le bord réel des capacités de la politique.
Gasgoo confirme les chiffres publiés par Boden AI et souligne que l’ensemble est centré sur les interventions pendant le fonctionnement du robot. Les fichiers conservent aussi les trajectoires propres à la politique, ce qui permet d’étudier ce que le système faisait avant et après la correction.
Notre analyse
RW-RL-HIL ne prouve pas à lui seul qu’un robot pourra apprendre à se sortir de toutes les situations. La valeur du corpus dépendra de la diversité des logements, des objets et des erreurs, ainsi que de la qualité des annotations. Il fournit néanmoins une matière rare : des échecs et des récupérations issus d’un robot physique, avec des frontières explicites entre contrôle autonome et intervention humaine.
Pour les équipes qui développent des politiques robotiques, ce type de données peut déplacer l’objectif. Il ne s’agit plus seulement d’augmenter le taux de réussite sur une tâche bien définie, mais d’apprendre quand demander de l’aide, comment récupérer et à quel moment reprendre sans danger. Cette capacité est centrale pour passer d’une démonstration contrôlée à un robot réellement exploitable.