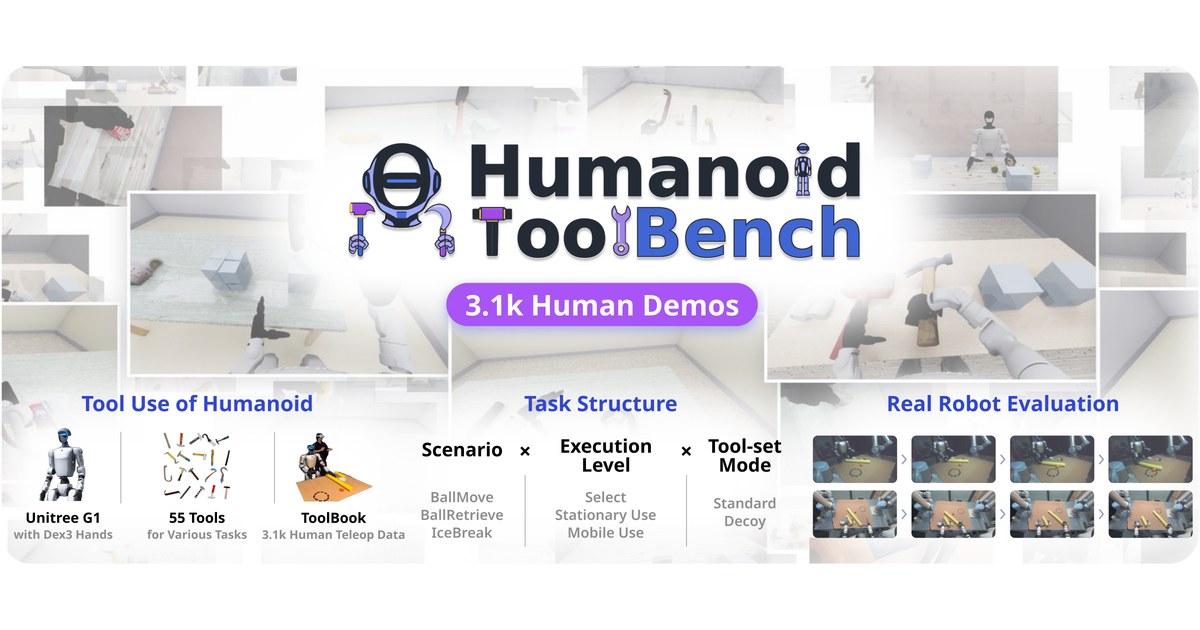
Une équipe de recherche a présenté HumanoidToolBench, un benchmark qui mesure la capacité d’un humanoïde à choisir un outil, se déplacer avec lui et terminer une tâche. L’évaluation comprend 18 tâches, 3 100 démonstrations et des essais sur un Unitree G1 réel.
Le travail, déposé sur arXiv le 1er octobre, part d’une limite simple : un humanoïde ne peut pas accomplir toutes les tâches avec ses seules mains. Il doit identifier l’outil adapté, le saisir correctement puis coordonner locomotion et manipulation. Les benchmarks existants évaluent souvent l’une de ces briques, mais rarement toute la chaîne.
Dix-huit tâches et trois niveaux d’exécution
HumanoidToolBench organise ses 18 tâches autour de trois scénarios, de trois niveaux d’exécution et de deux configurations d’outils. Le jeu de données associé, ToolBook, rassemble 3 100 démonstrations collectées en simulation et sur un Unitree G1 physique.
Les tâches demandent au robot de raisonner sur la fonction des objets avant de les utiliser. La difficulté ne consiste donc pas seulement à reproduire une trajectoire. Le système doit relier une instruction, les outils disponibles et les mouvements nécessaires, puis maintenir cette décision pendant une action qui peut exiger un déplacement du corps entier.
Les auteurs ont testé sept politiques en simulation et trois sur le robot réel. Leurs résultats mettent en évidence un écart important entre le choix d’un outil plausible et l’achèvement effectif de la tâche. Une politique peut reconnaître ce qu’il faudrait utiliser, mais échouer au moment de la prise, du transport ou de l’action finale.
GR00T N1.7 reste fragile face aux outils inconnus
Des tests ciblés avec GR00T N1.7 montrent également une baisse de précision lorsque les outils n’ont pas été vus auparavant. Les chercheurs signalent aussi que le modèle peut continuer une exécution alors qu’il reçoit une instruction sans rapport avec la tâche. Ce comportement pose un problème de contrôle : savoir agir ne suffit pas si le robot ne sait pas interrompre une séquence incohérente.
Le projet publie son code et ses données, ce qui doit faciliter la comparaison de nouvelles politiques sur les mêmes scénarios. La présence d’essais réels est importante, car les erreurs de contact, d’équilibre ou de perception sont souvent atténuées en simulation.
Notre analyse
HumanoidToolBench déplace l’évaluation vers une compétence plus proche des usages attendus d’un robot polyvalent. Dans un atelier ou un domicile, le système devra choisir entre plusieurs outils, marcher jusqu’à la zone de travail et adapter sa prise à une situation qui n’est pas parfaitement répétable.
Le benchmark ne prouve pas qu’un humanoïde est prêt pour ces environnements. Il fournit plutôt une méthode pour mesurer où la chaîne casse. Les premiers résultats suggèrent que la planification sémantique progresse plus vite que l’exécution physique complète. Rendre cet écart visible est une étape nécessaire pour comparer les modèles au-delà de démonstrations soigneusement sélectionnées.
Sources : article HumanoidToolBench sur arXiv et site officiel du projet avec code, données et vidéos.